Le système
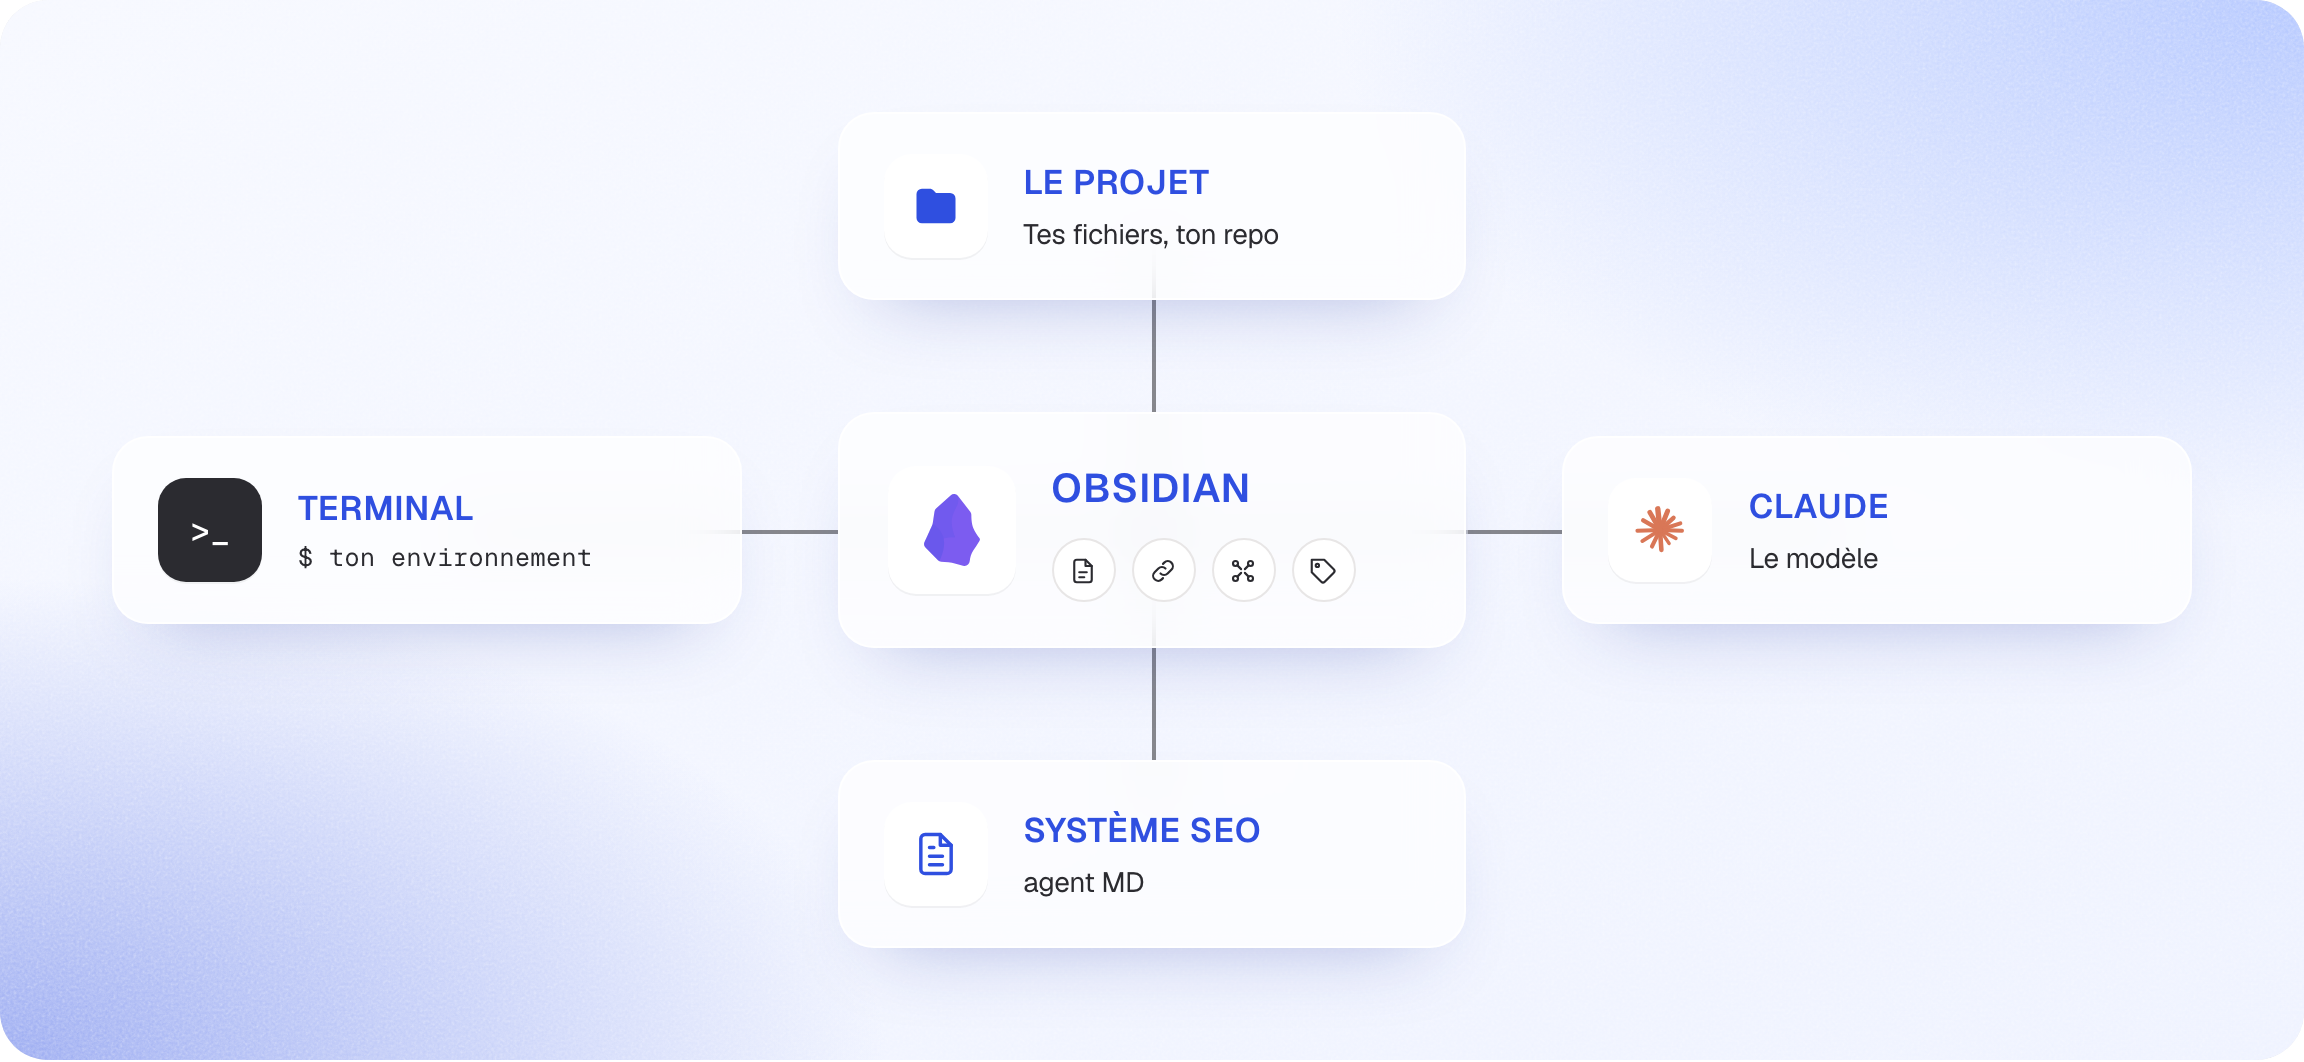
Le projet
Tes fichiers, ton repo. Tu ouvres le terminal dans ce dossier.
Terminal
Claude Code tourne dans ton terminal.
Les skills sont rangés dans ~/.claude/skills/, un dossier par skill avec son fichier SKILL.md. Claude Code les lit au démarrage.
Tu lances un skill en écrivant ta demande. Il n'y a pas de commande à retenir.
Obsidian
Claude oublie le contexte d'une conversation à l'autre. Obsidian garde la mémoire, en local.
La base suit le modèle LLM wiki d'Andrej Karpathy : le LLM écrit et maintient son propre wiki.
raw/ garde les sources brutes : appels clients, exports Search Console, articles. Claude ne modifie jamais ce dossier.
wiki/ est la partie organisée par Claude. Il y relie les sources de raw/.
Les notes se relient par des liens [[nom-de-page]] et portent des tags.
Claude
Le modèle. À chaque nouvelle conversation, il repart de ce qui est déjà écrit dans wiki/.
Système SEO
Un fichier markdown, AGENTS.md, que Claude lit au début de chaque session.
Il pose les règles : raw/ en lecture seule, une source pour chaque chiffre, pas de source, pas d'affirmation.
Il dit quel skill lancer pour chaque demande, et dans quel dossier de wiki/ ranger le résultat.
Google Search Console
Les exports Search Console vont dans raw/.
Quatre skills les lisent : seo-mots-cles-business, seo-quick-win, seo-cannibalisation, maillage-interne-gsc.
Mots-clés business
name: seo-mots-cles-business

description: Trie les mots-clés d’un site par intention business, avec ou sans Search Console. Trois portes, cinq décisions, aucun volume inventé. Déclencheurs : “mots-clés business”, “quels mots-clés cibler”, “sur quoi mon site doit se battre”.

# Mots-clés business

## Ce que tu donnes à Claude

- L’offre et le point de conversion (devis, rendez-vous, achat).
- La cible, le marché, la langue.
- Les URL des pages d’offre.
- L’export Search Console Requêtes + Pages, 3 à 6 mois, si tu l’as.
- Des verbatims clients, si tu en as.

## Consigne

> Lance seo-mots-cles-business sur [URL]. Offre : [...], cible : [...], conversion : [...], marché : [...].

## Étapes

1. Liste les requêtes hors marque. Regroupe les variantes d’un même besoin en une intention. Signale chaque fusion.

2. Sans Search Console, collecte Google Suggest, recherche web et verbatims. Deux requêtes qui partagent le même top 10 vont sur une seule page.

3. Écarte ce qu’une IA répond sans clic : définition, « comment », fait unique. Garde achat, prix, comparatif, avis, local.

4. Passe chaque intention aux trois portes :
- Correspond à l’offre ? Oui / Non.
- Intention business ? Forte / Moyenne / Faible, lue aux modificateurs, jamais au volume.
- Opportunité démontrée ? Déjà captée / Nouvelle / Non démontrée.

5. Décide : POUSSER, CRÉER, CONSOLIDER, ÉCARTER ou À VALIDER.

## Demande observée

Écris Faible / Moyenne / Forte, avec les signaux nommés à côté.

Forte : 5 variantes Suggest ou plus, 7 mentions en calls ou plus.

Seules 20 impressions Search Console ou plus confirment la demande.

## Sortie

- Diagnostic en une phrase.
- 3 à 5 chiffres, avec source et période.
- Quatre tableaux : intentions captées, opportunités sans page, pages qui sous-performent, requêtes écartées avec leur raison.
- 3 actions maximum, chacune justifiée par sa porte.
- Ce que les données ne permettent pas de conclure.

## Règles

- Aucun volume, position ou CPC inventé.
- Aucun score sur 10.
- Une requête à fort volume hors offre finit ÉCARTÉE, raison écrite.
- La Search Console ne montre pas tout le marché.
- Aucune page créée par automatisme. Cherche d’abord une URL ou un contenu existant.

Enregistre la sortie dans `AAAA-MM-JJ-<site>-mots-cles-business.md`.
Audit d'indexation
---
name: indexation-check
description: |
  Audit d'indexation d'un site (B2B / éditorial / pSEO) sans outil tiers payant. Vérifie 9 points sur chaque URL : statut HTTP, blocages techniques, directives noindex, sitemap (présence + lastmod + cohérence), maillage interne entrant, longueur de contenu, statut d'indexation Google estimé. Sortie : rapport markdown avec synthèse, anomalies critiques en tête, anomalies mineures, recommandations priorisées. Distingue strictement "non indexée" et "non testable" (rate-limit Google). Aucune action de forçage, lecture seule sur le web public.

  TOUJOURS utiliser ce skill quand l'utilisateur dit : "audit indexation", "check indexation", "monitoring indexation", "vérifier l'indexation", "mes pages sont-elles indexées", "agent indexation", "routine indexation mensuelle", ou quand il fournit une liste d'URLs / un sitemap / un fichier `urls.txt` / `articles.ts` / `wiki.ts` en demandant un diagnostic d'indexation.

  Ce skill est conçu pour tourner en one-shot (audit ponctuel) ou en récurrent mensuel via `/schedule`. Cible : sites de 30 à 1 000 pages. Au-delà, brancher l'API Google Search Console officielle (voir section "Variante haute fiabilité").
---

# Skill — Audit d'indexation Claude

## Quand déclencher

- Audit ponctuel d'un site (avant call commercial, après une refonte, après un déploiement de cluster)
- Monitoring mensuel récurrent sur un client en accompagnement
- Diagnostic d'une chute de trafic non expliquée
- Pré-flight d'un projet pSEO (vérifier que la base technique est saine avant de scaler)

## Input requis

| Source | Obligatoire |
|--------|-------------|
| Liste des URLs à monitorer (fichier dans le repo : `urls.txt`, `src/data/wiki.ts`, `src/data/articles.ts`) OU URL du sitemap.xml public du site | Oui |
| Domaine cible (ex : `site-client.fr`) | Oui |
| Périmètre du maillage à crawler (pages hubs : `/`, `/glossaire`, `/wiki`, footer, articles) | Recommandé |
| Service account GSC API (upgrade fiabilité) | Optionnel |

Minimum viable : une liste d'URLs et le domaine. Le reste se déduit.

## Architecture (3 couches)

```
1. Charger la liste des URLs (source de vérité humaine)
        ↓
2. COUCHE A — Audit technique (causes potentielles)
        ↓
3. COUCHE B — Statut d'indexation observable
        ↓
4. COUCHE C — Reporting markdown
```

La séparation causes / statut est volontaire. Le check v1 ne regardait que le statut, donc disait "OK 200" même quand la page portait un `noindex` accidentel. Le check v2 sépare strictement les deux.

## Pipeline (9 checks)

### COUCHE A — Audit technique (causes)

**1. HTTP check (404/500, redirects)**
Pour chaque URL :
```bash
curl -sIL -A "Mozilla/5.0" -o /dev/null -w "%{http_code}|%{url_effective}" {URL}
```
Note le code final ET la chaîne de redirects. 200 attendu. Toute redirection 301→200 systématique = dette à signaler (trailing slash, http→https).

**2. robots.txt non bloquant**
```bash
curl -s https://{domaine}/robots.txt
```
Pour chaque path, vérifie qu'aucune directive `Disallow:` ne le bloque pour `User-agent: *` ni `User-agent: Googlebot`.

**3. Pas de balise noindex (HTML + en-tête HTTP)**
```bash
curl -sL -A "Mozilla/5.0" {URL} | grep -i 'name="robots"'
curl -sIL {URL} | grep -i 'x-robots-tag'
```
Signaler toute présence de `noindex` ou `none`.

**4. Sitemap : présence + fraîcheur**
```bash
curl -s https://{domaine}/sitemap.xml
```
Pour chaque slug attendu, vérifie présence d'une `<loc>` et lis le `<lastmod>` associé. Flagger tout `lastmod` > 6 mois.

**5. Cohérence sitemap ↔ source de vérité**
Diff entre les slugs de la SOT (fichier humain) et les `<loc>` du sitemap :
- Slugs en source mais absents du sitemap → à ajouter au build
- `<loc>` en sitemap mais absente de la source → orpheline sitemap

**6. Maillage interne entrant**
Crawl les pages hubs (`/`, `/glossaire`, `/wiki`, footer, sample d'articles) et compte les liens internes entrants par URL cible.
- 0 lien entrant = orpheline (critique)
- 1 seul lien entrant = sous-maillée (à signaler)

**7. Longueur de contenu (proxy thin content)**
Pour chaque URL, extrais le texte du `<main>` ou `<article>` (à défaut du `<body>` moins `<nav>` et `<footer>`) et compte les mots.
- < 300 mots = thin (à creuser)
- 300-800 = court mais acceptable pour fiche atomique
- > 800 = OK

### COUCHE B — Statut d'indexation (sortie)

**8. Indexation Google estimée (scraping `site:`)**
```bash
curl -sL -A "Mozilla/5.0 (Macintosh...)" "https://www.google.com/search?q=site:{URL}&hl=fr"
```
**Garde-fous obligatoires :**
- Espacer les requêtes de 3 à 5 secondes (`sleep 4`)
- Détecter le blocage : `grep -E 'sorry/index|recaptcha|unusual traffic'`
- Si bloqué : marquer "non testable — rate limit", **pas** "non indexée"
- Retry une fois si réponse vide avant de conclure
- Marquer "indexée" si l'URL apparaît dans le HTML de réponse

Fiabilité ~40-60 % à cause du rate-limit. Pour 100 % de fiabilité, voir la variante GSC API.

### COUCHE C — Reporting

**9. Rapport markdown**
Structure obligatoire :
- Synthèse en tête (X/N par dimension, `✅` pour validé, `⚠️` pour anomalie)
- Anomalies CRITIQUES (action immédiate) — `noindex` accidentel, page orpheline, 404 sur page business
- Anomalies mineures — `lastmod` > 6 mois, sous-maillage, thin content
- Recommandations priorisées (2-5 actions, classées par impact estimé)
- Section "Limites du rapport" (ce qui n'a pas pu être testé et pourquoi)

## Sortie obligatoire

```markdown
# Indexation check — {domaine} — {date}

## Synthèse

Vérifications validées :
✅ {check} : X / N
✅ ...

Vérifications avec anomalies :
⚠️ {check} : X / N ({Y détails})
⚠️ ...

## Anomalies CRITIQUES (action immédiate)

⚠️ {URL} — {anomalie détectée}
   {contexte : depuis quand, impact estimé en impressions ou clics}
   → {action concrète à mener}

## Anomalies mineures

- {liste compactée des points secondaires}

## Recommandations priorisées

1. {action 1} — {effort estimé}, {impact estimé}
2. {action 2} — ...
3. {action 3} — ...

## Limites de ce rapport

- {ce qui n'a pas pu être testé et pourquoi : rate-limit Google, JS rendu côté client, etc.}
```

## Garde-fous (NON-NÉGOCIABLES)

- **Lecture seule** sur le web public. Aucune requête authentifiée non explicitement autorisée.
- **Aucune action de forçage d'indexation.** Pas de soumission GSC, pas de force-crawl.
- **Pas de modification du site.** Pas de PR sur les fichiers source. Sortie limitée à `reports/` ou directement dans la conversation.
- **Distinction stricte** "non indexée" vs "non testable" dans le rapport.
- **Priorité au signalement** : un `noindex` accidentel sur une page business doit remonter en TOP du rapport, pas en ligne 47 du tableau.
- Si un check échoue, continuer les autres et signaler dans la section "Limites".

> Discipline : observation côté agent, décision côté humain. Un agent qui peut "réparer" peut aussi tout casser un dimanche à 3 h du matin.

## Variante haute fiabilité — GSC URL Inspection API

Si l'utilisateur dispose d'un service account Google Cloud + propriété GSC :
1. Lire la clé JSON via secret stocké côté projet
2. Signer un JWT, échanger contre access token
3. POST sur `https://searchconsole.googleapis.com/v1/urlInspection/index:inspect`
4. Statuts officiels disponibles : `INDEXED`, `DISCOVERED_NOT_INDEXED`, `CRAWLED_NOT_INDEXED`, `URL_IS_UNKNOWN_TO_GOOGLE`

Passe le check #8 de ~50 % à 100 % de fiabilité. Setup ~30 minutes. Lève le rate-limit Google (limite officielle 2 000 inspections / jour / propriété).

## Variante site JS rendu côté client (SPA)

Si le contenu principal est rendu côté client (Single Page Application), `curl` ne verra qu'une coquille HTML quasi vide. Brancher Playwright headless :
1. Lancer un browser headless
2. Charger l'URL, attendre `networkidle`
3. Comparer le HTML rendu vs le HTML servi par le serveur
4. Signaler tout contenu uniquement présent post-JS (= invisible pour les crawlers qui n'exécutent pas le JS)

À réserver aux sites SPA ou aux clusters critiques (~30 s par URL).

## Récurrence — programmation via `/schedule`

Pour transformer l'audit ponctuel en monitoring continu :
```
/schedule
```
Choix structurants :
- **Récurrence** : `cron_expression: "0 1 1 * *"` (1er de chaque mois, 01h UTC)
- **Alternative one-shot** : `run_once_at` à J+14 après un déploiement de cluster
- **Modèle** : `claude-sonnet-4-6` (Opus inutile pour ce job)
- **Tools** : `Bash, Read, Write, Edit, Glob, Grep`
- **Environment** : Default Anthropic Cloud

À chaque exécution : 5 à 10 min de tourner-en-fond, rapport posté dans la conversation (ou push d'une PR si configuré côté repo).

## Réutilisation client

Pour appliquer ce skill à un client en accompagnement :
1. Créer un fichier `urls-prio.txt` dans son repo (top 30 pages business) OU pointer le sitemap public
2. Adapter le périmètre du maillage (hubs spécifiques au site)
3. Schedule cron mensuel
4. Inclure le rapport mensuel dans la note de suivi

Coût marginal par client : ~15 min de setup, 0 € récurrent. À facturer dans la rétro mensuelle ou comme bonus différenciant en pitch.

## Concepts liés

`grounding-score` · `passage-ranking`


## Phase apprentissage (boucle)

Cette phase tourne APRES la production. Elle ne change jamais le code du skill toute seule.

1. **Briefing memoire** (debut de run, AVANT de produire) : lire `/Users/timothee/Code/seo-kb/loops/indexation-check/manifest.yml` puis
   `/Users/timothee/Code/seo-kb/loops/indexation-check/memory/` (directives, score-grid, wording_rules, questions) et `/Users/timothee/Code/seo-kb/loops/indexation-check/ledgers/said_index.jsonl`
   pour ne pas repeter un angle deja couvert.

2. **Production** : faire le travail du skill normalement, en appliquant directives + score-grid.

3. **Ledger date** (append-only, jamais reecrire) dans `/Users/timothee/Code/seo-kb/loops/indexation-check/ledgers/` :
   - `runs.jsonl` : 1 ligne {date, ce qui a ete produit, `capture_mode`: "native"}.
   - `claims.jsonl` : 1 ligne par fait/chiffre, avec sources (>=2 dont 1 primaire) et `capture_mode`.
   - `predictions.jsonl` : si le run produit du mesurable, 1 pari date {id, enonce, `resolve_by`: AAAA-MM-JJ (J+30 ou J+90)}.
   - `said_index.jsonl` : angles/sujets couverts ce run.
   - `mistakes.jsonl` : ce qui a sous-performe (rempli a la resolution, pas a la prod).

4. **Gate** : lancer `../_loop-kit/validate.sh /Users/timothee/Code/seo-kb/loops/indexation-check` (ou `./validate.sh`). Si echec : corriger, ne pas commit.
   Optionnel : `../_loop-kit/eval_health.py /Users/timothee/Code/seo-kb/loops/indexation-check` pour le signal OK / WATCH / ESCALATE.

5. **Propositions de code** : si la boucle "voudrait" changer le skill (nouvelle regle, seuil, formulation),
   elle NE le fait pas. Elle ecrit le diff propose + la raison dans `/Users/timothee/Code/seo-kb/loops/indexation-check/memory/questions.md`. Tim tranche a la revue.

Regle d'or : **autonome sur la data, supervise sur le code.**
Core Web Vitals
---
name: seo-core-web-vitals
description: |
  Audit Core Web Vitals (LCP, CLS, TBT) d'un site via Lighthouse local sur un échantillon d'URLs depuis sitemap.xml. Mobile-first. Produit un tableau de scores par URL + problèmes récurrents site-wide + plan de correction priorisé pour les 5 pires pages.

  TOUJOURS utiliser ce skill quand l'utilisateur dit : "audit Core Web Vitals", "audit CWV", "perf SEO", "LCP CLS TBT", "Lighthouse audit", "vitesse de chargement", "audit performance site", "pourquoi mon site est lent en SEO", "PageSpeed score", "audit perf mobile", "score Lighthouse", "audit Web Vitals".

  Skill du périmètre SEO technique. Complémentaire de `indexation-check`, `seo-donnees-structurees`, `seo-cannibalisation`, `maillage-systeme`.
---

# Skill — Audit Core Web Vitals (Lighthouse local)

## Quand déclencher

Diagnostic de performance SEO d'un site complet, ou avant intervention technique (refonte, optimisation perf, migration). Toujours mobile (Google = mobile-first indexing).

## Pré-requis (à vérifier en début de skill)

```bash
which lighthouse || echo "MANQUANT — installer : npm install -g lighthouse"
which jq || echo "MANQUANT — installer : brew install jq"
```

Si Lighthouse manque, proposer `npm install -g lighthouse` à l'utilisateur et stopper. Ne pas installer silencieusement.

Alternative sans install globale : remplacer `lighthouse` par `npx lighthouse` dans toutes les commandes (premier lancement plus lent).

## Input requis

| Source | Obligatoire | Défaut |
|--------|-------------|--------|
| URL du sitemap.xml (ex. `https://site.com/sitemap.xml`) | Oui | — |
| Échantillon | Non | 50 URLs |
| Mode `all` (audit toutes les URLs du sitemap) | Non | off |

## Pipeline (5 étapes)

### Étape 1 — Récupérer le sitemap

```bash
SITEMAP_URL="<url>"
curl -sL "$SITEMAP_URL" | grep -oE '<loc>[^<]+</loc>' | sed -E 's|</?loc>||g' > /tmp/cwv-urls.txt
wc -l /tmp/cwv-urls.txt
```

**IMPORTANT (compat BSD/macOS)** : utiliser `sed -E 's|</?loc>||g'` et **PAS** `sed 's|</\?loc>||g'` — le `\?` ne marche pas en sed BSD (macOS) et laisse les balises intactes silencieusement.

**Si le sitemap est un index** (contient `<sitemapindex>` au lieu de `<urlset>`), récupérer le premier sitemap enfant et l'utiliser :

```bash
FIRST_CHILD=$(curl -sL "$SITEMAP_URL" | grep -oE '<loc>[^<]+</loc>' | sed -E 's|</?loc>||g' | head -1)
curl -sL "$FIRST_CHILD" | grep -oE '<loc>[^<]+</loc>' | sed -E 's|</?loc>||g' > /tmp/cwv-urls.txt
```

### Étape 2 — Échantillonner

```bash
TOTAL=$(wc -l < /tmp/cwv-urls.txt | tr -d ' ')
if [ "$TOTAL" -gt 50 ] && [ "$MODE" != "all" ]; then
  head -50 /tmp/cwv-urls.txt > /tmp/cwv-sample.txt
else
  cp /tmp/cwv-urls.txt /tmp/cwv-sample.txt
fi
wc -l /tmp/cwv-sample.txt
```

Les 50 premières URLs du sitemap sont généralement les plus prioritaires (homepage, hubs, top articles). Si l'utilisateur demande `all`, auditer toutes les URLs.

### Étape 3 — Lancer Lighthouse mobile en parallèle (3 workers)

```bash
rm -rf /tmp/cwv-results /tmp/cwv-errors.log
mkdir -p /tmp/cwv-results
cat /tmp/cwv-sample.txt | xargs -I {} -P 3 sh -c '
  url="$1"
  hash=$(echo -n "$url" | md5)
  lighthouse "$url" \
    --output=json \
    --output-path="/tmp/cwv-results/${hash}.json" \
    --only-categories=performance \
    --form-factor=mobile \
    --screenEmulation.mobile=true \
    --chrome-flags="--headless=new --no-sandbox" \
    --quiet 2>/dev/null || echo "FAIL: $url" >> /tmp/cwv-errors.log
' _ {}
echo "Results: $(ls /tmp/cwv-results/ 2>/dev/null | wc -l | tr -d ' ')"
[ -f /tmp/cwv-errors.log ] && echo "Errors:" && cat /tmp/cwv-errors.log
```

**IMPORTANT (zsh-safe)** : utiliser `rm -rf /tmp/cwv-results && mkdir -p /tmp/cwv-results` et **PAS** `rm -f /tmp/cwv-results/*` — le glob vide fait gueuler zsh (`no matches found`) et l'exit code 1 peut interrompre la suite.

**`--headless=new`** (et pas `--headless` legacy) — plus stable depuis Chrome 109+, requis pour Lighthouse 13.

**Compter** : ~15-30 secondes par URL avec 3 workers parallèles. 50 URLs ≈ 5-10 min.

### Étape 4 — Parser les résultats

Pour chaque JSON dans `/tmp/cwv-results/`, extraire avec jq (chemin Lighthouse 13) :

```bash
for f in /tmp/cwv-results/*.json; do
  jq '{
    url: .finalDisplayedUrl,
    lcp_ms: (.audits."largest-contentful-paint".numericValue // 0),
    cls: (.audits."cumulative-layout-shift".numericValue // 0),
    tbt_ms: (.audits."total-blocking-time".numericValue // 0),
    score: ((.categories.performance.score // 0) * 100),
    lcp_element: [.audits."lcp-breakdown-insight".details.items[]? | select(.type == "node") | {selector, snippet, nodeLabel}] | .[0],
    lcp_breakdown: [.audits."lcp-breakdown-insight".details.items[]? | select(.type == "table") | .items[]? | {subpart, label, duration_ms: .duration}],
    opportunities: [.audits | to_entries[] | select(.value.details.type == "opportunity" and (.value.details.overallSavingsMs // 0) > 100) | {id: .key, title: .value.title, savings_ms: .value.details.overallSavingsMs}] | sort_by(-.savings_ms) | .[0:5]
  }' "$f"
done | jq -s '.' > /tmp/cwv-parsed.json
echo "Parsed: $(jq 'length' /tmp/cwv-parsed.json) URLs"
```

**Chemins clés Lighthouse 13** :
- URL finale : `.finalDisplayedUrl` (et **PAS** `.finalUrl` qui peut être null)
- LCP element : `.audits."lcp-breakdown-insight".details.items[] | select(.type == "node")` (et **PAS** `.audits."largest-contentful-paint-element"` qui est null depuis LH 13)
- LCP breakdown (TTFB / render delay / load delay) : `.audits."lcp-breakdown-insight".details.items[] | select(.type == "table") | .items[]` — utile pour diagnostiquer **où** se passe le temps LCP

**Seuils Google (à appliquer pour le verdict)** :

| Métrique | Good | Needs Improvement | Poor |
|----------|------|-------------------|------|
| LCP | < 2500 ms | 2500-4000 ms | > 4000 ms |
| CLS | < 0.1 | 0.1-0.25 | > 0.25 |
| TBT (proxy INP) | < 200 ms | 200-600 ms | > 600 ms |
| Score perf | ≥ 90 | 50-89 | < 50 |

### Étape 5 — Produire le rapport markdown

Voir section "Output obligatoire" ci-dessous.

### Étape 4bis — Détection automatique du pattern "redirect sitemap"

Si l'opportunity `redirects` apparaît sur **>50% des pages auditées** avec un gain moyen >300ms : c'est quasi-certainement un mismatch de trailing slash entre le sitemap et le serveur.

```bash
REDIRECT_COUNT=$(jq -r '.[] | .opportunities[] | select(.id == "redirects") | .id' /tmp/cwv-parsed.json | wc -l | tr -d ' ')
TOTAL=$(jq 'length' /tmp/cwv-parsed.json)
if [ "$REDIRECT_COUNT" -gt $((TOTAL / 2)) ]; then
  echo "⚠️ ALERTE : $REDIRECT_COUNT/$TOTAL pages ont une redirection. Vérifier le trailing slash du sitemap vs serveur."
fi
```

Ce pattern doit être mis EN TÊTE du rapport — c'est le quick win le plus rentable quand il est présent.

## Output obligatoire

```markdown
# Audit Core Web Vitals — [domaine] — [date]

**Échantillon** : X URLs auditées / Y URLs dans le sitemap. **Form factor** : mobile.
**Note importante** : INP non mesurable en local par Lighthouse (métrique field). TBT utilisé comme proxy.

## Scores par URL

| URL | LCP | CLS | TBT | Score | Verdict |
|-----|-----|-----|-----|-------|---------|
| / | 1.8s ✅ | 0.05 ✅ | 150ms ✅ | 92 | Good |
| /blog/article-x | 4.2s ❌ | 0.18 ⚠️ | 720ms ❌ | 38 | Poor |
| /categorie/y | — | — | — | — | ERROR (timeout) |

Légende : ✅ Good — ⚠️ Needs Improvement — ❌ Poor

## Synthèse

- **X/Y pages** sont en Poor (score < 50)
- **X/Y pages** ont un LCP > 4s (critique pour le ranking)
- **X/Y pages** ont un CLS > 0.25 (UX dégradée)
- Score perf médian : X / Score perf moyen : Y

## Problèmes récurrents site-wide

Opportunities Lighthouse qui apparaissent sur > 30% des pages auditées :

1. **Unused JavaScript** — X pages affectées — gain moyen estimé : Xs
   - Cause probable : [bundle non tree-shaké / scripts tiers (analytics, chat, ads)]
2. **Render-blocking resources** — X pages — gain moyen : Xs
3. **Image sizing / Properly size images** — X pages — gain moyen : Xs
4. **Largest Contentful Paint image** — X pages — gain moyen : Xs
5. **Reduce JavaScript execution time** — X pages — gain moyen : Xs

## Top 5 pages à corriger en priorité

(triées par score perf croissant)

### 1. /blog/article-x (score : 38)
- **LCP** : 4.2s ❌ — élément : `<img class="hero" src="...">` (selector : `main > article > img.hero`)
  - Breakdown : TTFB 800ms / load delay 1200ms / load duration 1500ms / render delay 700ms
  - → Le gros du temps part en **load delay** (image découverte tardivement)
- **CLS** : 0.18 ⚠️ — shifts probables : pub Adsense / images sans dimensions
- **TBT** : 720ms ❌ — JS bloquant : [scripts identifiés]

**Plan de correction** :
1. Préload de l'image hero LCP + `fetchpriority="high"`
2. Définir width/height explicites sur toutes les images du contenu
3. Defer les scripts non critiques (analytics, chat) — passer en `loading="lazy"` les iframes

**Lecture du LCP breakdown** :
- TTFB > 600ms → problème serveur / CDN / cache
- Load delay > 200ms → image LCP pas dans le HTML initial (lazy, dans CSS background, JS-injectée)
- Load duration > 500ms → image trop lourde ou pas servie en format moderne (avif/webp)
- Render delay > 300ms → blocage CSS/JS render-blocking ou hydratation lente

### 2. ...

(répéter pour les 5 plus mauvaises)

## Limites de l'audit

- INP non mesuré (Lighthouse lab → TBT comme proxy)
- Pas de variation par device réel (émulation Moto G Power)
- Pas de mesure sur connexion réelle (throttling 4G simulé)
- Pour les vraies données field : croiser avec PageSpeed Insights API ou CrUX
```

## Règles absolues

- **Mobile uniquement** — Google indexe en mobile-first. Pas de desktop par défaut.
- **INP non mesuré** — toujours préciser dans le rapport que TBT est utilisé comme proxy.
- **Pas de score halluciné** — si une URL échoue (timeout, 404, JS error), la marquer `ERROR` dans le tableau, pas `0` ou un placeholder.
- **Pas de reco sans opportunity Lighthouse correspondante** — ne pas inventer "il faudrait optimiser X" si Lighthouse ne l'a pas remonté pour cette page.
- **Pas d'installation silencieuse** — si Lighthouse manque, demander à l'utilisateur de l'installer.
- **Échantillon honnête** — si l'échantillon est de 50/2000 URLs, le dire clairement, ne pas extrapoler "tout le site" à partir de 2,5% du contenu.

## Edge cases

- **Sitemap index** (sitemapindex au lieu d'urlset) → récupérer le premier child + l'utiliser, signaler à l'utilisateur qu'il peut spécifier un sitemap enfant précis pour cibler.
- **Sitemap protégé** (auth, 403) → demander à l'utilisateur un export local des URLs.
- **Plus de 500 URLs avec mode `all`** → confirmer avec l'utilisateur (sera lent : 500 URLs × ~10s/3 workers ≈ 30 min).
- **Site en SPA ou auth-walled** → certaines pages peuvent timeout, c'est normal, les marquer ERROR.
- **Sitemap multi-langues** → garder tel quel, le rapport montrera les écarts par locale.
Pages proches du top 3
---
name: seo-quick-win
description: >
  Identifier les opportunités SEO à impact rapide depuis les données GSC.
  Pages en position 3-12 avec impressions élevées et CTR sous-performant.

  TOUJOURS utiliser ce skill quand l'utilisateur mentionne : quick win, gains rapides,
  opportunités immédiates, pages à optimiser vite, "qu'est-ce que je peux améliorer sans rédiger",
  "quelles pages sont proches du top 3", "résultats court terme", "on est en position 4-10",
  optimisation rapide, pages sous-performantes, CTR faible, ou uploade un export GSC
  et veut des actions immédiates.
---

# Skill 01 — Quick Win SEO

## Rôle

Identifier dans les données GSC les pages positionnées entre la position 3 et 12, avec un volume d'impressions élevé et peu de clics. Prioriser les optimisations à impact rapide sans créer de nouveau contenu.

**Logique de priorité :**
1. Optimiser les pages existantes d'abord
2. Ensuite seulement, proposer de créer les pages pour les mots-clés qui font des impressions sans page dédiée

---

## Réflexion appliquée (méthode Organikk)

- Le vrai signal d'opportunité, c'est le **delta entre impressions et clics**, pas le volume.
- Être top 3 est l'objectif — pas "être visible". **Position 4 = invisible commercialement.**
- On ne rédige pas pour ranker. On optimise ce qui existe d'abord. La création vient ensuite.
- Un quick win SEO corrige un décalage entre l'intention de la requête et ce que la page délivre réellement.
- Avant de proposer du nouveau contenu, **vider le backlog d'opportunités GSC.**
- Un quick win GEO inclut la **densification des "Preuves Atomiques"** : remplacer les phrases littéraires ou le bruit marketing par le schéma [Sujet + Relation + Entité/Valeur] dans les premiers paragraphes.

---

## Données requises

| Source | Description | Obligatoire |
|--------|-------------|-------------|
| Export GSC Pages | URL, Clics, Impressions, CTR, Position moyenne (90 jours) | Oui |
| Contexte secteur | Secteur d'activité, offre du client | Recommandé |

**Minimum viable :** Export GSC avec au moins 30 jours de données, filtre position 4–15, tri impressions décroissant.

---

## Raisonnement de l'agent (étapes obligatoires)

L'agent DOIT suivre ces étapes **dans l'ordre** avant de répondre.

### Étape 1 — Filtrer
Filtrer les pages entre position 3.0 et 15.0. Exclure :
- Pages branded (contenant le nom de marque)
- Homepage

### Étape 2 — Trier
Trier par impressions décroissantes → identifier les 10 pages avec le plus fort potentiel manqué.

### Étape 3 — Calculer le gap CTR
Pour chaque page, calculer le gap CTR :

| Position | CTR attendu |
|----------|-------------|
| 4 | ~7% |
| 5 | ~5% |
| 6-10 | ~2-3% |
| 11-15 | ~1-2% |

**Gap = CTR attendu - CTR réel**

### Étape 4 — Croiser avec l'intention
Identifier l'intention de chaque requête principale :
- **Décisionnelle** (prix, comparatif, meilleur, avis) → priorité maximale
- **Transactionnelle** (achat, urgence, devis) → priorité haute
- **Informationnelle** (comment, pourquoi, guide) → priorité basse

### Étape 5 — Prioriser
Critères de priorité maximale :
- Pages décisionnelles
- Impressions élevées (>500/mois)
- CTR < 3%
- Gap CTR > 1.5%

### Étape 6 — Lister les leviers
Pour chaque page retenue, identifier les leviers d'optimisation :
- Balise title (inclure chiffres, bénéfice, différenciateur)
- Méta-description (CTA, preuve sociale)
- Structure Hn (H1 avec data, H2 alignés sur intentions)
- FAQ en haut de page (question = requête principale)
- Contenu du premier écran (densification atomique)
- Preuves atomiques : [Sujet + Relation + Entité/Valeur]

**NE PAS répondre avant d'avoir complété chaque étape.**

---

## Format de sortie OBLIGATOIRE

### Tableau de 5 à 10 pages quick win priorisées

```
QUICK WIN — Top [N] Opportunités GSC

| # | URL | Position | Impressions | CTR réel | CTR attendu | Delta | Intent |
|---|-----|----------|-------------|----------|-------------|-------|--------|
| 1 | /exemple-page | 6.2 | 12 400 | 1.8% | 3.5% | -1.7% | Déc. |
```

### Fiche action par page (minimum 2 actions dont 1 preuve atomique)

```
→ Page /exemple-page

Action 1 : [Type d'action] — [Description concrète]
Action 2 : [Type d'action] — [Description concrète]
Action 3 : Densification atomique — [Exemple avant/après]
```

---

## Exemple de sortie attendue

```
QUICK WIN — Top 5 Opportunités GSC

| # | URL | Position | Impressions | CTR réel | CTR attendu | Delta | Intent |
|---|-----|----------|-------------|----------|-------------|-------|--------|
| 1 | /service/serrurier-lyon | 6.2 | 12 400 | 1.8% | 3.5% | -1.7% | Déc. |
| 2 | /prix-remplacement-batterie | 7.8 | 8 900 | 2.1% | 3.0% | -0.9% | Déc. |
| 3 | /urgence-plombier-paris | 5.1 | 6 200 | 3.2% | 5.0% | -1.8% | Trans. |

→ Page /service/serrurier-lyon

Action 1 : Réécrire le title — inclure prix indicatif + délai
         Avant : "Serrurier Lyon - Intervention rapide"
         Après : "Serrurier Lyon : 89€ - Intervention en 30 min 24h/24"

Action 2 : Ajouter bloc Q&A en top de page (question = requête principale)
         "Combien coûte un serrurier à Lyon ?" → réponse directe chiffrée

Action 3 : Densification atomique du premier paragraphe
         Avant : "Notre équipe intervient rapidement pour tous vos problèmes de serrurerie"
         Après : "Intervention serrurier Lyon en 30 minutes. Tarif : 89€ jour, 129€ nuit.
                  Agréé assurance. 4.8/5 sur 847 avis Google."
```

---

## Ce que l'agent NE DOIT PAS faire

- Proposer de créer de nouvelles pages avant d'avoir épuisé les quick wins existants
- Recommander des optimisations sans s'appuyer sur les données GSC réelles
- Confondre volume de recherche et impressions GSC — ce sont deux métriques différentes
- Donner des conseils génériques ("améliorez votre CTR") sans action concrète sur l'URL concernée
- Ignorer l'intention business de la page — une page informationnelle en position 8 n'est pas forcément une priorité
- Oublier la densification atomique — c'est le levier GEO le plus rapide

---

## Critère de qualité

La sortie est **bonne** si :

1. Chaque page retenue a un **delta CTR chiffré**
2. Chaque page a une **intention identifiée** (Déc./Trans./Info.)
3. Chaque page a **au moins 2 actions concrètes**
4. Au moins **1 action de preuve atomique** avec exemple avant/après
5. **Aucune recommandation générique** dans la sortie
Cannibalisation
---
name: seo-cannibalisation
description: >
  Détecter et résoudre les cas de cannibalisation entre pages SEO. Identifier quand
  plusieurs pages se concurrencent sur les mêmes mots-clés ou intentions, classifier
  le type de conflit, et recommander l'action corrective appropriée.

  TOUJOURS utiliser ce skill quand l'utilisateur mentionne : cannibalisation, pages qui
  se mangent entre elles, keyword cannibalism, "deux pages sur le même mot-clé",
  "je rankais mieux avant", "ma page principale baisse alors que j'ai publié un article similaire",
  "comment savoir si mes pages se concurrencent", chutes de positions inexpliquées,
  conflit entre pages, pages en compétition interne, ou uploade des données GSC montrant
  plusieurs URLs sur les mêmes requêtes.
---

# Skill 02 — Cannibalisation SEO

## Rôle

Détecter les cas de cannibalisation entre pages (par intention ou par mot-clé direct), les classer par type de risque, et recommander une action corrective précise — sans simplifier à outrance une problématique qui est, par nature, complexe.

---

## Réflexion appliquée (méthode Organikk)

- Il existe **plusieurs types de cannibalisation** : par mot-clé direct, par intention de recherche proche, par similarité sémantique. Ne pas les confondre.
- La cannibalisation **n'est pas toujours un problème** — parfois deux pages se complètent. L'agent doit distinguer conflit réel et coexistence saine.
- Le **diagnostic doit précéder la solution**. Comparer les URLs en GSC avant de recommander une action.
- La solution **n'est jamais binaire** : fusionner, rediriger, différencier ou supprimer — chaque cas a sa réponse propre.
- Vérifier si le conflit apparent n'est pas en réalité une opportunité de **"Triade SERP"** (cibler plusieurs positions sur la même requête avec des angles complémentaires).

---

## Données requises

| Source | Description | Obligatoire |
|--------|-------------|-------------|
| Export GSC Requêtes | Filtré par URL, 90 jours — pour identifier quelles pages apparaissent sur les mêmes requêtes | Oui |
| Liste des URLs | Scraping ou sitemap — pour croiser les pages thématiquement proches | Recommandé |
| Contexte stratégique | Pages piliers vs pages satellites | Recommandé |

**Minimum viable :** Export GSC requêtes + au moins 2 URLs suspectes à comparer.

---

## Raisonnement de l'agent (étapes obligatoires)

### Étape 1 — Identifier les conflits

Identifier les requêtes déclenchant plusieurs URLs dans la GSC :
- Filtrer par requête
- Repérer les requêtes où 2+ pages apparaissent
- Lister les paires/groupes de pages en conflit

### Étape 2 — Classifier le type de cannibalisation

| Type | Description | Exemple |
|------|-------------|---------|
| **(A) Mot-clé exact** | Deux pages ciblent exactement le même mot-clé | /serrurier-paris et /serrurier-paris-urgence sur "serrurier paris" |
| **(B) Même intention** | Deux pages répondent à la même intention utilisateur | /prix-serrure et /tarif-serrurier sur l'intention "combien ça coûte" |
| **(C) Proximité sémantique** | Deux pages couvrent des sujets très proches sans conflit direct | /guide-serrure-3-points et /comparatif-serrures |
| **(Triade SERP)** | Opportunité, pas conflit — les pages couvrent des corpus distincts | /accident-voiture et /accident-voiture-veteran (micro-intentions différentes) |

### Étape 3 — Analyser les métriques

Pour chaque page en conflit, relever :

| Métrique | Page A | Page B |
|----------|--------|--------|
| Position moyenne | | |
| Impressions | | |
| Clics | | |
| CTR | | |

→ Identifier la **page gagnante** (meilleure performance globale)

### Étape 4 — Évaluer l'architecture stratégique

Déterminer le rôle de chaque page dans le cluster :
- **Page pilier** (doit gagner) vs **Page satellite** (doit soutenir)
- Quelle page est la plus alignée avec l'objectif business ?
- Quelle page a le meilleur potentiel de conversion ?

### Étape 5 — Recommander l'action corrective

| Situation | Action recommandée |
|-----------|-------------------|
| Type A + page perdante faible | **Redirection 301** de la perdante vers la gagnante |
| Type A + deux pages fortes | **Fusion** du contenu + 301 |
| Type B + micro-intentions distinctes | **Différenciation** des angles + maillage croisé |
| Type C + complémentarité | **Renforcement du maillage** vers la page pilier |
| Triade SERP | **Aucune action** — optimiser chaque page sur son angle |

**NE PAS répondre avant d'avoir complété chaque étape.**

---

## Format de sortie OBLIGATOIRE

### Tableau de diagnostic

```
CANNIBALISATION DÉTECTÉE

Requête ciblée : '[requête]'
Type : (A/B/C/Triade) [Description]

| URL | Position | Impressions | Clics | CTR | Statut |
|-----|----------|-------------|-------|-----|--------|
| /page-1 | X.X | X XXX | XXX | X.X% | Page gagnante |
| /page-2 | X.X | X XXX | XXX | X.X% | Page perdante |
```

### Diagnostic et action

```
→ Diagnostic : [Explication du conflit]

→ Action recommandée : [Action précise avec justification]

→ Implémentation :
  1. [Étape concrète 1]
  2. [Étape concrète 2]
  3. [Étape concrète 3]
```

---

## Exemple de sortie attendue

```
CANNIBALISATION DÉTECTÉE

Requête ciblée : 'serrurier paris urgence'
Type : (B) Même intention de recherche

| URL | Position | Impressions | Clics | CTR | Statut |
|-----|----------|-------------|-------|-----|--------|
| /serrurier-paris | 4.2 | 9 200 | 380 | 4.1% | Page gagnante |
| /urgence-serrurier-paris | 8.7 | 4 100 | 62 | 1.5% | Page perdante |

→ Diagnostic : Les deux pages ciblent la même intention urgente.
  La page /serrurier-paris capte l'essentiel du trafic.
  La page /urgence dilue l'autorité sans apporter de valeur distincte.

→ Action recommandée : DIFFÉRENCIATION (pas fusion)
  Les micro-intentions sont distinctes : urgence générique vs urgence nuit/weekend.

→ Implémentation :
  1. Repositionner /urgence-serrurier-paris sur l'angle "nuit et weekend" exclusivement
  2. Modifier le H1 : "Serrurier Paris Nuit & Weekend — Intervention 23h-6h"
  3. Ajouter maillage interne depuis /urgence vers /serrurier-paris (ancre : "serrurier paris")
  4. Supprimer les mentions "urgence jour" de /urgence pour éviter le chevauchement
```

---

## Cas particulier : Triade SERP (faux positif)

```
ANALYSE — Requête : 'indemnisation accident voiture'

| URL | Position | Angle couvert |
|-----|----------|---------------|
| /accident-voiture | 3.2 | Guide général indemnisation |
| /accident-voiture-veteran | 7.1 | Spécificités pour vétérans |

→ Diagnostic : PAS DE CANNIBALISATION
  Les deux pages couvrent des corpus distincts (général vs spécifique).
  Google les affiche toutes deux car elles répondent à des micro-intentions différentes.

→ Action : Aucune. Opportunité de Triade SERP.
  Optimiser chaque page sur son angle pour maximiser le score RRF.
```

---

## Ce que l'agent NE DOIT PAS faire

- Recommander systématiquement une redirection 301 sans analyser les métriques des deux pages
- Ignorer le type de cannibalisation — traiter toutes les cannibalisations de la même façon
- Confondre **duplication de contenu** et **cannibalisation** — ce sont deux problèmes différents
- Analyser les pages en silo, sans tenir compte de leur rôle dans le cluster sémantique
- Proposer une solution avant d'avoir classifié le type de conflit (A/B/C/Triade)
- Fusionner des pages avec des micro-intentions distinctes — c'est détruire de la valeur

---

## Critère de qualité

La sortie est **bonne** si :

1. Chaque paire en conflit est **classifiée par type** (A/B/C/Triade SERP)
2. La **page gagnante est identifiée** avec justification chiffrée (position, clics, CTR)
3. L'**action recommandée est différente** selon le type détecté
4. L'implémentation contient **au moins 3 étapes concrètes**
5. Les cas de **Triade SERP sont identifiés** comme opportunités (pas comme problèmes)
Matrice objectif × secteur
---
name: seo-mots-cles-overview
description: |
  Spécialiste mot-clé OVERVIEW (GEO / Google AI Overviews). Cartographie l'univers de mots-clés d'un terme-pilier concurrentiel (« agent », « consultant », « logiciel »…) en croisant DEUX axes : l'objectif principal (tous les buts / jobs-to-be-done de la personne) × le secteur d'activité (toutes les verticales). Sort une matrice objectif × secteur, chaque croisement qualifié sur son potentiel d'être cité en AI Overview / réponse LLM. Brique AMONT du workflow mots-clés : sa matrice alimente seo-recherche-mots-cles → seo-clustering-mots-cles → seo-mots-cles-decisionnels.

  TOUJOURS utiliser ce skill quand l'utilisateur dit : "se placer sur [terme]", "spécialiste mot-clé overview", "matrice objectif secteur", "cartographie mot-clé", "tous les objectifs et tous les secteurs", "univers de mots-clés d'un terme-pilier", "comment ranker sur un mot générique/concurrentiel", "être cité en AI Overview sur [terme]", "GEO sur le mot [terme]".
---

# Skill — Spécialiste Mot-Clé OVERVIEW (GEO)

## Quand déclencher

Un terme-pilier générique et concurrentiel (« agent », « consultant », « logiciel », « formation »…) est trop large pour être attaqué frontalement. On ne rank pas sur « agent » ; on rank en couvrant **tout l'univers** que le mot recouvre. Ce skill construit cet univers en croisant deux axes, puis qualifie chaque croisement pour la visibilité dans les **AI Overviews et les réponses génératives (GEO)**.

C'est la **première brique** du workflow mots-clés quand on part d'un mot-pilier large. Sa matrice devient la matière de `seo-recherche-mots-cles`.

## Doctrine

- **GEO d'abord.** OVERVIEW = Google AI Overviews / SGE, SearchGPT, Perplexity, citations LLM. Jamais SEO local. L'objectif n'est pas seulement de ranker, c'est d'**être la source citée** dans la réponse générée.
- **On ne rank pas sur le pilier, on rank sur ses croisements.** Le mot « agent » seul est ingagnable et sans intention. « Agent IA pour prospecter dans l'immobilier » est gagnable, intentionné, et citable.
- **Deux axes, jamais un seul.** Un mot-clé de valeur est toujours un objectif × un secteur. Sortir un axe sans l'autre produit une liste plate qui rate la moitié de l'univers.
- **Exhaustivité des deux axes avant tout croisement.** On génère d'abord TOUS les objectifs, puis TOUS les secteurs, ensuite on croise. Générer large, filtrer après.
- **Le vault décide.** Objectifs et secteurs s'ancrent sur la data réelle (verbatims, GSC, corpus). Le vault mince = on le signale, on n'invente pas de secteurs fantômes.
- **Volume optionnel** : affiché seulement s'il vient d'une donnée réelle, jamais estimé. Difficulté et potentiel AI Overview = proxys déclaratifs, jamais des chiffres inventés.

## Le principe de la matrice — 2 axes

```
                 SECTEUR D'ACTIVITÉ  →
                 immobilier | e-commerce | avocat | SaaS | santé | …
OBJECTIF ↓
rédiger            agent IA rédaction immobilier | …
prospecter         agent IA prospection immobilier | …
support client     agent IA SAV e-commerce | …
prise de RDV       …
veille / analyse   …
…
```

Chaque cellule = un mot-clé candidat = **un terme-pilier + un objectif + un secteur**. La valeur du skill est de rendre les DEUX axes exhaustifs avant de croiser.

## Input requis

| Source | Obligatoire |
|--------|-------------|
| Terme-pilier (le mot générique visé : « agent », « consultant »…) | Oui |
| Marché géo + langue | Oui |
| Offre / point de conversion (pour qualifier le funnel plus tard) | Recommandé |
| Verbatims Reddit / avis / support (pour ancrer les objectifs réels) | Recommandé — rend l'axe Objectif crédible |
| Export GSC / Keyword Planner si dispo | Recommandé — révèle secteurs et objectifs déjà performants |

## Pipeline (6 étapes)

1. **Isoler le terme-pilier + son objectif racine.** Que veut fondamentalement la personne qui tape ce mot ? (« agent » → déléguer une tâche à une IA autonome). C'est le sens qui contraint les deux axes.

2. **Axe OBJECTIF PRINCIPAL — exhaustif.** Lister tous les buts / jobs-to-be-done que la personne poursuit avec le pilier. Sources : verbatims réels, patterns « pour + verbe », People Also Ask, cas d'usage du corpus. Viser **15 à 30 objectifs** avant tri. Ex. pour « agent » : rédiger, prospecter, répondre au support, qualifier des leads, prendre des RDV, faire de la veille, analyser des données, automatiser un workflow, traduire, modérer…

3. **Axe SECTEUR D'ACTIVITÉ — exhaustif.** Lister toutes les verticales / métiers qui achètent le pilier. Sources : secteurs présents dans le corpus, clients existants, PAA « pour [métier] ». Viser **15 à 40 secteurs** avant tri. Ex. : immobilier, e-commerce, avocat, expert-comptable, restaurant, SaaS B2B, santé, assurance, RH, artisan…

4. **Croiser en matrice.** Objectif × Secteur. Ne pas tout garder : couper les cellules absurdes (objectif incompatible avec le secteur) et les doublons sémantiques. Garder les croisements plausibles où une audience réelle cherche.

5. **Qualifier chaque croisement retenu (GEO).** Pour chaque cellule shortlistée :
   - **Intention** : Know-Simple / Know / Do (cf. `seo-cluster-aeo`).
   - **Potentiel AI Overview** : ce croisement déclenche-t-il probablement une réponse générée (Fort / Moyen / Faible) — proxy déclaratif, jamais présenté comme certitude. Les Know-Simple et comparatifs (« meilleur agent IA pour X », « comment automatiser Y ») déclenchent le plus souvent un AI Overview.
   - **Angle de citation** : ce qu'il faut fournir pour ÊTRE la source citée (définition nette, donnée originale, comparatif, procédure pas-à-pas). Cf. `seo-entites-vectorielles` / `seo-geo-audit`.

6. **Livrable + passage de relais.** Sortir la matrice + la shortlist priorisée, puis passer la main à `seo-recherche-mots-cles` (qui fera l'expansion longue traîne de chaque croisement retenu).

## Output obligatoire

```
OVERVIEW MOT-CLÉ — terme-pilier : '[agent]'   ([marché] · [langue])
Objectif racine : [ce que la personne veut fondamentalement]

AXE OBJECTIFS ([n]) : rédiger · prospecter · support · RDV · veille · …
AXE SECTEURS ([n])  : immobilier · e-commerce · avocat · SaaS · santé · …

MATRICE PRIORISÉE
| Croisement (mot-clé) | Objectif | Secteur | Intention | AI Overview | Angle de citation |
|---|---|---|---|---|---|
| agent IA rédaction pour l'immobilier | rédiger | immobilier | Know | Fort | Procédure + exemple de fiche générée |
| meilleur agent IA prospection e-commerce | prospecter | e-commerce | Know/Do | Fort | Comparatif chiffré |
| … | | | | | |

Synthèse : [n] objectifs × [n] secteurs → [n] croisements retenus
Top croisements GEO (fort potentiel de citation) : [liste]
Prochaine étape : seo-recherche-mots-cles sur les [n] croisements retenus.
```

## Règles absolues

- **Toujours les deux axes.** Un livrable OVERVIEW sans axe Objectif OU sans axe Secteur est incomplet et se refait.
- **Exhaustivité d'abord** : générer chaque axe large (15-30 objectifs, 15-40 secteurs) avant de croiser et couper.
- **GEO, pas local.** « OVERVIEW » = AI Overviews génératifs. Ne jamais dériver vers le SEO géographique.
- **Volume optionnel.** Affiché seulement depuis une donnée réelle, jamais estimé. Difficulté et potentiel AI Overview restent des proxys déclaratifs, jamais des chiffres inventés. Si un export d'outil est fourni, utiliser SES chiffres.
- **Ancrer sur le réel.** Objectifs et secteurs viennent des verbatims / du corpus / de la GSC quand ils existent. Vault mince = le signaler, pas combler au hasard.
- Ne pas faire l'expansion longue traîne ici : c'est le rôle de `seo-recherche-mots-cles` en aval. Ce skill cadre l'univers, il ne le déroule pas.

## Enchaînement workflow

`seo-mots-cles-overview` (cette matrice, AMONT) → `seo-recherche-mots-cles` (expansion + qualification de chaque croisement) → `seo-clustering-mots-cles` (regroupe en pages) → `seo-mots-cles-decisionnels` (isole les convertisseurs) → `seo-cluster-aeo` / `seo-brief-contenu` / `seo-programmatique-pseo`.

Complémentaire : `seo-programmatique-pseo` et `seo-modeles-pseo` quand la matrice objectif × secteur est assez dense pour devenir un template pSEO (une page par cellule).

## Sauvegarde

Output dans `wiki/keywords/overview-YYYY-MM-DD-slug.md` selon le hook §7 AGENTS.md, puis update `wiki/index.md` + `wiki/log.md`.

## Concepts liés

`know-simple-know-do` · `ai-overview` · `geo` · `grounding-score` · `triade-serp` · `rag-structurer` · `clustering-mots-cles` · `mots-cles-decisionnels` · `pseo`
Recherche de mots-clés
---
name: seo-recherche-mots-cles
description: |
  Recherche de mots-clés from scratch : partir d'une thématique ou de quelques seed keywords et produire une liste exhaustive, qualifiée et priorisée — chaque mot-clé avec son intention et sa difficulté. Pipeline en 5 étapes : cadrer la thématique → expansion sémantique → qualification (intention/difficulté) → filtrage du bruit → tableau priorisé. Règle : volume optionnel (affiché seulement s'il vient d'une donnée réelle, jamais estimé), difficulté jamais inventée.

  TOUJOURS utiliser ce skill quand l'utilisateur dit : "recherche de mots-clés", "trouve-moi des mots-clés", "keyword research", "liste de mots-clés sur [thème]", "quels mots-clés cibler", "explore les requêtes sur", "j'ai une thématique, sors les mots-clés", "expansion de mots-clés".

  Première brique du workflow mots-clés : sa sortie alimente seo-clustering-mots-cles puis seo-mots-cles-decisionnels.
---

# Skill — Recherche de Mots-Clés

## Quand déclencher

Partir d'une thématique ou de seed keywords et produire une liste de mots-clés exhaustive, qualifiée et priorisée. C'est l'amont de tout : tant que la liste n'existe pas, ni le clustering ni le brief n'ont de matière.

## Doctrine

- **Colonne Volume optionnelle** : le volume figure dans le livrable si le chiffre vient d'une donnée réelle (Keyword Planner, Search Console, Ahrefs, Semrush), avec sa source. Sans donnée réelle, pas de colonne plutôt qu'un chiffre estimé. La difficulté reste un proxy déclaratif, jamais un chiffre inventé.
- On ne part pas des concurrents. On part de l'intention de l'audience et de l'offre.
- Un mot-clé sans intention claire n'est pas un mot-clé, c'est du bruit.
- Exhaustivité d'abord, tri ensuite : générer large, filtrer après.

## Input requis

| Source | Obligatoire |
|--------|-------------|
| Thématique ou 3-5 seed keywords | Oui |
| Secteur + audience / persona | Oui |
| Offre (ce qu'on vend, point de conversion) | Oui — sinon le funnel est inqualifiable |
| Marché géo + langue | Oui |
| Export GSC / Ahrefs / Semrush si dispo | Recommandé — rend les volumes réels |

## Pipeline (5 étapes)

1. **Cadrer** — thématique, périmètre, ce qui est dans le scope et ce qui en sort.
2. **Expansion sémantique** — pour chaque seed, générer :
   - modificateurs (comment, pourquoi, prix, avis, meilleur, vs, sans…)
   - questions (patterns People Also Ask)
   - longue traîne (3 mots et plus)
   - co-occurrences et entités liées
   - synonymes et variantes lexicales
   Objectif : **50 à 150 mots-clés bruts** minimum avant tri.
3. **Qualifier chaque mot-clé** — intention (Know-Simple / Know / Do, cf. `seo-cluster-aeo`), difficulté estimée (proxy : nb de mots, présence de marques, type de SERP), étage de funnel. (Volume : optionnel, uniquement depuis une donnée réelle.)
4. **Filtrer le bruit** — retirer hors-sujet, hors-intention vs l'offre, doublons stricts, requêtes branded concurrent non pertinentes.
5. **Livrable** — tableau priorisé.

## Output obligatoire

```
RECHERCHE MOTS-CLÉS — '[Thématique]'

| Mot-clé | Intention | Difficulté | Funnel | Note |
|---|---|---|---|---|
| ... | Know | Moyenne | Know | ... |
| ... | Do | Élevée | Décision | ... |

Synthèse : [nb total] mots-clés · [nb] Do · [nb] Know · [nb] Know-Simple
Top 5 à prioriser : [liste]
```

## Règles absolues

- **Volume optionnel** : affiché seulement s'il vient d'une donnée réelle, jamais estimé. Difficulté = proxy déclaratif, jamais un chiffre inventé.
- Si un export d'outil est fourni, utiliser **ses** chiffres, ne jamais les arrondir ni les estimer au hasard.
- Générer large (50+ avant filtrage), livrer trié.
- Chaque mot-clé a une intention identifiée, ou il dégage de la liste.

## Enchaînement workflow

`seo-recherche-mots-cles` (cette liste) → `seo-clustering-mots-cles` (regroupe en pages) → `seo-mots-cles-decisionnels` (isole les convertisseurs) → `seo-brief-contenu` / `seo-cluster-aeo` / `seo-programmatique-pseo`.

## Sauvegarde

Output dans `wiki/keywords/recherche-YYYY-MM-DD-slug.md` selon hook §7 AGENTS.md.

## Concepts liés

`know-simple-know-do` · `funnel` · `rrf` · `clustering-mots-cles` · `mots-cles-decisionnels` · `brief-contenu`
Mots-clés résistants à l'IA
---
name: seo-mots-cles-resistants-ia
description: |
  Trie une liste de mots-clés ou une thématique en deux camps : ceux que Google AI Overviews, ChatGPT et Perplexity répondent déjà directement sans clic (informationnel, absorbé), et ceux qui résistent parce qu'ils demandent un choix contextualisé qu'une réponse générique ne peut pas trancher (achat, comparaison, avis, local, marque). Extrait du skill seo-mots-cles-decisionnels, mais allégé : pas de scoring de conversion ni de ciblage de page, juste le tri anti-absorption.

  TOUJOURS utiliser ce skill quand l'utilisateur dit : "mots-clés pas mangés par l'IA", "mots-clés que ChatGPT n'absorbe pas", "quels mots-clés résistent à l'IA", "trie par risque d'absorption IA", "mots-clés résistants aux AI Overviews", "quels mots-clés vont encore amener du clic".

  Brique amont du workflow mots-clés : les mots-clés "résistants" obtenus ici passent ensuite dans seo-mots-cles-decisionnels pour le scoring de conversion et le ciblage de page complet.
---

# Skill — Mots-clés résistants à l'IA

## Quand déclencher

Trier, dans une liste ou une thématique, les requêtes qui continuent d'amener un clic humain de celles que Google AI Overviews, ChatGPT ou Perplexity répondent déjà à la place du site.

## Doctrine

- Une IA répond bien à « qu'est-ce que X » ou « comment faire X ». Elle répond mal à « je dois choisir entre X et Y pour MON cas, avec MES contraintes ».
- L'absorption touche l'informationnel générique : définitions, tutoriels, chiffres publics, questions à réponse unique et vérifiable. C'est exactement le contenu qu'une réponse de trois phrases épuise.
- Le décisionnel résiste parce qu'il engage un choix contextualisé (budget, secteur, taille d'équipe, contrainte locale) qu'une réponse générique ne couvre pas, et parce qu'il engage une responsabilité : personne ne clique « acheter » sur la foi d'un résumé IA sans vérifier la source.
- Le volume ne dit rien du risque d'absorption. Un mot-clé à fort volume mais purement définitionnel est le plus exposé, pas le moins.
- Le test rapide : une réponse générique et non sourcée de trois phrases satisferait-elle la requête ? Oui → absorbé. Non, il faut comparer, choisir ou vérifier avec du contexte propre → résistant.

## Signaux de résistance (table de modificateurs)

| Catégorie | Modificateurs | Pourquoi ça résiste |
|-----------|---------------|----------------------|
| **Achat direct** | acheter, commander, prix, tarif, devis, abonnement, s'inscrire | Engage une dépense, l'IA ne prend pas la responsabilité |
| **Comparaison** | meilleur, top, vs, comparatif, alternative à, lequel choisir | Le verdict dépend du profil de qui demande |
| **Évaluation** | avis, test, retour d'expérience, fiable, arnaque | Cherche une preuve vécue, pas un résumé |
| **Local / immédiat** | près de moi, [ville], en ligne, livraison, ouvert | Contexte géographique ou temporel que l'IA généralise mal |
| **Marque** | [ta marque], [ta marque] avis/prix, [nom d'outil] alternative | Cherche une confirmation ou une source spécifique |

À l'inverse, signal d'absorption : la requête commence par « qu'est-ce que », « comment », « pourquoi », « définition de », ou porte sur un chiffre/fait unique et stable dans le temps.

## Pipeline (3 étapes)

1. **Lister** — importer la liste de mots-clés, ou explorer la thématique si on part de zéro (variantes, questions associées, longue traîne).
2. **Tester** — appliquer le test de résistance à chaque mot-clé, confirmé par la table de modificateurs.
3. **Trancher** — sortir deux colonnes : absorbés (à ne pas prioriser en acquisition de clic classique) et résistants (prioritaires, ROI le plus sûr).

## Output obligatoire

```
MOTS-CLÉS RÉSISTANTS À L'IA — '[Thématique]'

| Mot-clé | Verdict | Pourquoi |
|---|---|---|
| ... | Résistant | Comparaison, choix contextualisé |
| ... | Absorbé | Définition à réponse unique |

Résistants à prioriser : [liste]
Absorbés à ne pas prioriser en SEO clic (candidats à un traitement GEO citation si la marque veut apparaître comme source) : [liste]
```

## Règles absolues

- Ne jamais classer résistant un mot-clé purement informationnel pour gonfler la liste.
- Le verdict se justifie toujours par le modificateur ou le test de résistance, jamais par intuition seule.
- Un mot-clé « absorbé » n'est pas un mot-clé à abandonner : il peut valoir un traitement GEO (citation dans la réponse IA) plutôt qu'un traitement SEO clic. Le dire explicitement dans l'output.

## Enchaînement workflow

Les mots-clés « résistants » → `seo-mots-cles-decisionnels` pour le scoring de conversion et le ciblage de page (landing, comparatif, page produit, page locale).

## Sauvegarde

Output dans `wiki/keywords/resistants-ia-YYYY-MM-DD-slug.md` selon hook §7 AGENTS.md.

## Concepts liés

`know-simple-know-do` · `funnel` · `grounding-score` · `geo` · `mots-cles-decisionnels` · `fully-meets`
Regroupement en clusters
---
name: seo-clustering-mots-cles
description: |
  Regroupe une liste brute de mots-clés en clusters exploitables — 1 cluster = 1 page. Critère de regroupement : le partage de SERP (deux mots-clés qui affichent le même top 10 = la même intention = une seule page). Pipeline en 5 étapes : importer la liste → normaliser (dédoublonner, nettoyer) → regrouper par intention de SERP → nommer chaque cluster et désigner le mot-clé pivot → affecter 1 cluster = 1 page avec détection de cannibalisation.

  TOUJOURS utiliser ce skill quand l'utilisateur dit : "cluster mes mots-clés", "groupe cette liste de mots-clés", "keyword clustering", "regroupe mes requêtes", "j'ai 200 mots-clés à organiser", "quels mots-clés vont sur la même page", "transforme ma liste en pages".

  Diffère de seo-cluster-aeo, qui part d'UN mot-clé pilier pour bâtir une architecture. Ici on part d'une LISTE BRUTE de N mots-clés et on la découpe en pages. Brique d'architecture du workflow mots-clés : après seo-recherche-mots-cles, avant seo-brief-contenu.
---

# Skill — Clustering de Mots-Clés

## Quand déclencher

Transformer une liste brute de N mots-clés en clusters exploitables, où chaque cluster devient une page.

## Doctrine

- Le vrai critère de clustering SEO = le **partage de SERP**. Si Google affiche le même top 10 pour deux requêtes, il les traite comme la même intention → une seule page.
- La proximité sémantique seule ne suffit pas. "Assurance auto pas chère" et "tarif assurance auto" se ressemblent mais peuvent avoir des SERP distinctes.
- 1 cluster = 1 page = 1 mot-clé pivot. Deux pages sur le même cluster = cannibalisation programmée.
- Sans accès aux SERP réelles, l'IA cluster par intention + sémantique **en proxy** : la sortie est une hypothèse à valider, jamais une vérité.

## Input requis

| Source | Obligatoire |
|--------|-------------|
| La liste brute de mots-clés (collage, CSV, sortie de `seo-recherche-mots-cles`) | Oui |
| Intention + volume par mot-clé | Recommandé |
| Données de SERP overlap d'un outil (Keyword Insights, Ahrefs "Parent topic") | Recommandé — rend le clustering fiable |
| Le site / l'offre (pour orienter le nommage et détecter la cannibalisation) | Recommandé |

## Pipeline (5 étapes)

1. **Importer la liste** — accepter un collage brut, un CSV ou la sortie de `seo-recherche-mots-cles`.
2. **Normaliser** — dédoublonner, retirer le bruit (mots-clés sans intention, branded concurrent hors scope), fusionner les variantes orthographiques strictes (singulier/pluriel, accents).
3. **Regrouper** — critère #1 : SERP overlap si la donnée est fournie. Sinon proxy : intention identique + même tête sémantique. Chaque groupe = un cluster.
4. **Nommer + pivot** — pour chaque cluster : nom (head term), intention dominante (Know-Simple / Know / Do), mot-clé pivot (le plus représentatif, plus fort volume) + mots-clés secondaires.
5. **Affecter** — 1 cluster = 1 page. Détecter les clusters qui recoupent une page existante → risque de cannibalisation, renvoyer vers `seo-cannibalisation`.

## Output obligatoire

```
CLUSTERS — '[Liste / thématique]'

| Cluster | Mot-clé pivot | Secondaires | Intention | Page (nouvelle / existante) | Risque cannibalisation |
|---|---|---|---|---|---|
| ... | ... | ... | Know | Nouvelle | — |

Non clusterisés : [mots-clés orphelins laissés seuls]
À valider : confirmer chaque cluster par un SERP overlap réel (outil ou vérification manuelle).
```

## Règles absolues

- 1 cluster = 1 page = 1 pivot. Jamais deux clusters sur la même intention (principe MECE).
- Un mot-clé n'appartient qu'à un seul cluster.
- Sans donnée SERP, marquer explicitement la sortie « hypothèse — à valider par overlap réel ».
- Ne pas forcer un mot-clé orphelin dans un cluster : le laisser en « non clusterisé ».
- Si un cluster recoupe une page live → flag cannibalisation, ne pas créer de doublon.

## Enchaînement workflow

Après `seo-recherche-mots-cles` → chaque cluster devient un input : `seo-brief-contenu` (1 cluster = 1 brief), ou `seo-cluster-aeo` si le cluster est assez gros pour devenir un pilier. Les clusters d'intention Do → `seo-mots-cles-decisionnels`.

## Sauvegarde

Output dans `wiki/keywords/clusters-YYYY-MM-DD-slug.md` selon hook §7 AGENTS.md.

## Concepts liés

`serp-overlap` · `mece` · `cannibalisation` · `cluster-aeo` · `passage-ranking` · `maillage-interne`
Mots-clés décisionnels
---
name: seo-mots-cles-decisionnels
description: |
  Isole les mots-clés décisionnels — les requêtes transactionnelles et bas de funnel qui convertissent, par opposition aux requêtes informationnelles qui ne font que du trafic. Pipeline en 5 étapes : définir l'offre et le point de conversion → repérer les signaux décisionnels → classer par étage de décision → scorer le potentiel de conversion → shortlist priorisée avec page et format recommandés. Part d'une liste existante ou d'une thématique.

  TOUJOURS utiliser ce skill quand l'utilisateur dit : "mots-clés décisionnels", "mots-clés transactionnels", "mots-clés qui convertissent", "requêtes bas de funnel", "requêtes Do", "mots-clés bottom funnel", "quels mots-clés rapportent", "trie ma liste par potentiel de conversion", "mots-clés commerciaux".

  Brique de conversion du workflow mots-clés : se branche après seo-recherche-mots-cles ou seo-clustering-mots-cles.
---

# Skill — Mots-Clés Décisionnels

## Quand déclencher

Isoler, dans une liste ou une thématique, les requêtes qui amènent un client — pas seulement du trafic.

## Doctrine

- Le trafic n'est pas l'objectif, la conversion l'est. Un mot-clé à 10 000 vues/mois sans intention d'achat vaut moins qu'un mot-clé à 80 vues qui amène un client.
- Un mot-clé décisionnel = l'internaute est en train de choisir, comparer ou acheter. Il a mentalement sorti la carte bleue.
- Le décisionnel se repère à ses **modificateurs**, pas à son volume.
- Bas de funnel ≠ forcément faible volume : "meilleur [catégorie]" peut peser lourd.
- Le décisionnel se traite en priorité : c'est le ROI le plus court du SEO.

## Input requis

| Source | Obligatoire |
|--------|-------------|
| Liste de mots-clés OU thématique | Oui |
| Offre : ce qu'on vend, prix, point de conversion (formulaire, achat, démo, appel) | Oui |
| Audience / persona | Oui |
| Autres acteurs du marché (pour les requêtes branded) | Recommandé |

## Signaux décisionnels (table de modificateurs)

| Catégorie | Modificateurs |
|-----------|---------------|
| **Achat direct** | acheter, commander, prix, tarif, devis, abonnement, s'inscrire |
| **Comparaison** | meilleur, top, vs, comparatif, alternative à, lequel choisir |
| **Évaluation** | avis, test, retour d'expérience, fiable, arnaque |
| **Local / immédiat** | près de moi, [ville], en ligne, livraison, ouvert |
| **Marque** | [ta marque], [ta marque] avis/prix, [nom d'outil] alternative |

## Étages de décision

- **Do — Achat** : l'internaute veut transformer maintenant.
- **Do — Comparatif** : il choisit entre options, toi inclus.
- **Do — Local** : intention d'achat + contrainte géographique.
- **Do — Marque** : il te connaît déjà, ou connaît un autre acteur du marché.
- **Know commercial** : "comment choisir un X" — pré-décision, à capter tôt.

## Pipeline (5 étapes)

1. **Définir l'offre** — ce qu'on vend, le prix, le point de conversion réel.
2. **Repérer les signaux** — passer la liste ou la thématique au filtre des modificateurs décisionnels.
3. **Classer par étage de décision** — ranger chaque mot-clé retenu.
4. **Scorer le potentiel de conversion** — proximité à l'offre (1-5) × intention d'achat (1-5) × faisabilité de ranker (1-5), produit ramené sur une **échelle 0-10 (arrondi entier)**. Flag les requêtes branded sur un autre acteur pour vérifier la légitimité.
5. **Livrable** — shortlist priorisée ; pour chaque mot-clé : page cible (landing, comparatif, page produit, page locale), format, CTA.

## Output obligatoire

```
MOTS-CLÉS DÉCISIONNELS — '[Offre]'

| Mot-clé | Étage | Score conv. /10 | Page cible | Format | CTA |
|---|---|---|---|---|---|
| ... | Do — Comparatif | 5/10 | Page comparatif | Tableau + verdict | Devis |

Top 3 à attaquer en premier : [liste + justification]
```

## Règles absolues

- Ne jamais classer décisionnel un mot-clé purement informationnel pour gonfler la liste.
- Requête branded sur un autre acteur → vérifier la légitimité : page comparative honnête, aucune tromperie.
- Chaque mot-clé décisionnel pointe vers une page avec offre + CTA, sinon il ne convertit pas.
- Prioriser proximité à l'offre + faisabilité, pas le volume brut.

## Enchaînement workflow

Après `seo-recherche-mots-cles` ou `seo-clustering-mots-cles` → alimente `seo-product-led-seo` (outils pour les requêtes Do) et `seo-brief-contenu` (pages de conversion).

## Sauvegarde

Output dans `wiki/keywords/decisionnels-YYYY-MM-DD-slug.md` selon hook §7 AGENTS.md.

## Concepts liés

`know-simple-know-do` · `funnel` · `product-led-seo` · `fully-meets` · `cannibalisation` · `e-e-a-t`
Cluster AEO
---
name: seo-cluster-aeo
description: |
  Construire des clusters sémantiques optimisés pour l'AEO (Answer Engine Optimization) et l'Agentic Search. Catégorise les pages satellites selon les intentions Know-Simple, Know et Do pour maximiser le score RRF (Reciprocal Rank Fusion).

  TOUJOURS utiliser ce skill quand l'utilisateur mentionne : cluster sémantique, cocon SEO, pages satellites, AEO, Answer Engine Optimization, Agentic Search, intentions de recherche, Know/Do, MECE, architecture de contenu, arborescence SEO, "quelles pages créer autour de [mot-clé]", stratégie de contenu SEO, maillage thématique, topical authority, ou veut planifier un ensemble de pages interconnectées.
---

# Clusters Sémantiques AEO / Agentic Search

Ce skill génère une architecture de contenu complète optimisée pour les moteurs de réponse (SGE, Perplexity, ChatGPT) et les agents IA autonomes.

## Quand utiliser ce skill

- Pour planifier une stratégie de contenu autour d'un mot-clé pilier
- Pour restructurer un site existant en clusters thématiques
- Pour identifier les gaps de contenu face aux concurrents
- Pour optimiser la visibilité dans les réponses IA (AEO)

## Concepts clés

### AEO (Answer Engine Optimization)
Optimisation pour les moteurs qui génèrent des réponses directes (Google SGE, Bing Copilot, Perplexity, ChatGPT avec browsing).

### Agentic Search
Optimisation pour les agents IA autonomes (MLE-STAR, AutoGPT, etc.) qui effectuent des recherches et actions pour l'utilisateur.

### Score RRF (Reciprocal Rank Fusion)
Algorithme qui combine les classements de plusieurs sources. Un cluster couvrant toutes les sous-intentions améliore le score global.

### Principe MECE
Mutuellement Exclusif, Collectivement Exhaustif. Chaque page couvre un angle unique, l'ensemble couvre toute la thématique.

## Instructions

### Étape 1 : Définir le mot-clé pilier

Demander à l'utilisateur :
1. **Le mot-clé pilier** (requête principale à dominer)
2. **Le secteur/niche** de l'entreprise
3. **Les ressources disponibles** (équipe rédaction, budget outils, données propriétaires)

### Étape 2 : Mapper les intentions selon le framework AEO

**ABANDONNER** le framework TOFU/MOFU/BOFU classique.

Utiliser les 3 types d'intentions des moteurs IA :

#### Intention "Know-Simple"
**Définition** : Questions factuelles avec réponse courte et unique.

Caractéristiques :
- Réponse en <50 mots
- Souvent affichée en Position 0 / Featured Snippet
- Les agents IA extraient directement la réponse
- Format idéal : définition, chiffre, date, nom

**Exemples** :
- "Quel est le prix moyen d'un audit SEO ?"
- "Définition du TF-IDF"
- "Durée moyenne d'une campagne SEO"

#### Intention "Know"
**Définition** : Questions nécessitant une explication approfondie.

Caractéristiques :
- Réponse longue avec structure et preuves
- Nécessite des données structurées (FAQ, How-to schema)
- Les agents IA synthétisent plusieurs sections
- Format idéal : guide, tutoriel, comparatif détaillé

**Exemples** :
- "Comment choisir une agence SEO ?"
- "Les étapes d'un audit technique complet"
- "Différences entre SEO on-page et off-page"

#### Intention "Do"
**Définition** : Micro-tâches que l'utilisateur (ou l'agent IA) veut accomplir.

Caractéristiques :
- Nécessite un outil, workflow ou action concrète
- Les agents IA autonomes peuvent l'exécuter à la place de l'humain
- Génère des leads qualifiés (échange valeur vs données)
- Format idéal : calculateur, simulateur, générateur, audit automatisé

**Exemples** :
- "Calculer le ROI d'une stratégie SEO"
- "Générer une checklist d'audit technique"
- "Simuler le trafic potentiel d'un mot-clé"

### Étape 3 : Générer le tableau du cluster

Créer un tableau avec **minimum 15 pages satellites** réparties selon les 3 intentions :

| Requête cible | Type d'intention | Format de landing page | Données structurées | Priorité |
|---------------|------------------|----------------------|--------------------|---------|
| [Requête longue traîne] | Know-Simple / Know / Do | [Format spécifique] | [Schema.org applicable] | Haute/Moyenne/Basse |

### Règles de répartition

Distribution recommandée :
- **Know-Simple** : 20-30% (quick wins pour Position 0)
- **Know** : 40-50% (autorité thématique)
- **Do** : 20-30% (génération de leads)

### Formats de landing page par intention

#### Know-Simple
- FAQ conversationnelle (une question = une page)
- Définition enrichie avec exemple
- Tableau de données (prix, délais, stats)
- Glossaire thématique

#### Know
- Guide ultime (3000+ mots)
- Comparatif structuré (tableau + analyse)
- Étude de cas détaillée
- Tutoriel pas-à-pas avec visuels

#### Do
- Calculateur interactif (ROI, budget, temps)
- Générateur (checklist, template, brief)
- Simulateur (trafic, revenus, positionnement)
- Outil d'audit gratuit (score + recommandations)
- Quiz/assessment avec résultat personnalisé

### Étape 4 : Définir le maillage interne

Pour chaque page, identifier :
1. **Liens entrants** : quelles pages du cluster pointent vers elle
2. **Liens sortants** : vers quelles pages elle pointe
3. **Ancres recommandées** : textes d'ancre optimisés

Règles de maillage :
- La page pilier reçoit des liens de toutes les pages satellites
- Les pages "Do" reçoivent des liens des pages "Know" (parcours : apprendre → agir)
- Les pages "Know-Simple" servent de passerelles vers les pages "Know"

### Étape 5 : Priorisation et roadmap

Classer les pages par priorité selon :
1. **Volume de recherche** de la requête cible
2. **Difficulté de positionnement** (concurrence)
3. **Potentiel de conversion** (intention commerciale)
4. **Effort de production** (contenu vs outil)

## Notes importantes

- Chaque page doit avoir une requête cible UNIQUE (principe MECE)
- Les pages "Do" nécessitent souvent un développement technique
- Réviser le cluster tous les 6 mois selon les évolutions de la SERP
- Les agents IA privilégient les contenus structurés et actionnables
Peurs et objections
---
name: seo-objections
description: |
  Identifier les peurs, objections et pain points d'une audience B2B pour créer du contenu à haute conversion. Génère des verbatims "Haute Surprise" et des preuves atomiques pour rassurer les prospects déçus par leurs expériences passées.

  TOUJOURS utiliser ce skill quand l'utilisateur mentionne : objections clients, peurs prospects, pain points, freins à l'achat, verbatims clients, "pourquoi ils n'achètent pas", "qu'est-ce qui bloque mes prospects", analyse des réticences, copywriting B2B, arguments de vente, réassurance client, "comment convaincre un prospect échaudé", ou veut comprendre la psychologie d'achat de sa cible.
---

# Analyse des Peurs et Objections B2B

Ce skill génère une analyse approfondie des freins psychologiques d'une audience B2B pour alimenter une stratégie de contenu persuasif.

## Quand utiliser ce skill

- Avant de rédiger une page de vente ou landing page
- Pour créer du contenu de réassurance (FAQ, témoignages, garanties)
- Pour briefer une équipe commerciale sur les objections terrain
- Pour identifier les angles de différenciation face aux concurrents

## Instructions

### Étape 1 : Définir le contexte

Demander à l'utilisateur :
1. **La thématique/produit/service** concerné
2. **Le persona cible** (fonction, taille d'entreprise, secteur)
3. **Les expériences négatives passées** connues de cette cible (si disponibles)

### Étape 2 : Générer le tableau d'analyse

Adopter le rôle d'un directeur marketing B2B qui a été déçu par des prestataires similaires dans le passé. Générer un tableau avec **10 lignes minimum** contenant :

| Micro-intention / Pain Point | Verbatim "Haute Surprise" | Preuve Atomique attendue |
|------------------------------|---------------------------|--------------------------|
| Nom précis du frein | Citation experte, rare ou inattendue qui sort des clichés pour capter l'attention algorithmique | Donnée binaire/chiffrée/factuelle au format Sujet + Verbe + Donnée |

### Règles pour les Verbatims "Haute Surprise"

Les verbatims doivent :
- Éviter les clichés du secteur (ex: "je veux du ROI" → trop générique)
- Exprimer une frustration experte ou technique rarement verbalisée
- Utiliser un vocabulaire spécifique au métier du persona
- Révéler une connaissance terrain que seul un initié possède

**Exemples de transformation :**
- Low Surprise : "Je veux voir des résultats concrets"
- High Surprise : "La dernière agence m'envoyait des rapports de 40 pages où le seul KPI lisible était le nombre de backlinks, sans jamais croiser ça avec mon CRM"

### Règles pour les Preuves Atomiques

Format obligatoire : **Sujet + Verbe + Donnée**

Les preuves doivent être :
- Vérifiables (pas de superlatifs vagues)
- Binaires ou chiffrées (oui/non, X%, X€, X jours)
- Spécifiques au pain point correspondant

**Exemples :**
- "Notre méthodologie génère +47% de leads qualifiés en moyenne sur 6 mois"
- "100% de nos clients ont accès à un dashboard temps réel connecté à leur CRM"
- À éviter : "Nous offrons un excellent accompagnement" (non vérifiable)

### Étape 3 : Priorisation

Après le tableau, classer les 3 objections les plus critiques selon :
1. **Fréquence** : combien de prospects l'expriment
2. **Intensité** : niveau de blocage à la décision
3. **Différenciation** : capacité à se démarquer en y répondant

### Étape 4 : Recommandations de contenu

Pour chaque objection prioritaire, suggérer :
- Le format de contenu idéal (case study, calculateur, garantie, FAQ)
- L'emplacement recommandé sur le site
- Le CTA associé

## Notes importantes

- Ce skill génère du contenu stratégique, pas du contenu final prêt à publier
- Les verbatims peuvent servir de base pour des interviews clients réelles
- Les preuves atomiques doivent être validées par l'entreprise avant publication
Entités sémantiques
---
name: seo-entites-vectorielles
description: |
  Analyser les entités sémantiques nécessaires pour aligner le vecteur d'une page avec l'intention de recherche. Génère les termes techniques, preuves quantitatives, vecteurs multimodaux et éléments de divergence pour maximiser le Grounding Score (similarité cosinus).

  TOUJOURS utiliser ce skill quand l'utilisateur mentionne : entités sémantiques, vecteurs SEO, intention de recherche, alignement sémantique, Grounding Score, similarité cosinus, recherche vectorielle, "quels termes inclure dans ma page", "comment matcher l'intention utilisateur", optimisation sémantique, NLP SEO, embeddings, ou veut maximiser la pertinence algorithmique d'une page.
---

# Analyse des Entités Vectorielles pour le SEO

Ce skill génère la cartographie sémantique complète nécessaire pour qu'une page s'aligne mathématiquement avec l'intention de recherche ciblée.

## Quand utiliser ce skill

- Avant de rédiger une nouvelle page de contenu
- Pour optimiser une page existante qui sous-performe
- Pour construire un brief éditorial exhaustif
- Pour comprendre le "gap sémantique" avec les concurrents

## Concepts clés

### Grounding Score / Similarité Cosinus
Mesure de l'alignement entre le vecteur de votre page et le vecteur de l'intention utilisateur. Plus le score est élevé, plus votre page est considérée comme pertinente.

### Recherche vectorielle (Muvera, etc.)
Les moteurs modernes utilisent des embeddings pour comparer sémantiquement les pages aux requêtes, au-delà de la simple correspondance de mots-clés.

### Surprise Gap
Les éléments "Haute Surprise" (concepts experts rares) forcent la mémorisation par les modèles IA, contrairement aux éléments "Low Surprise" (présents partout).

## Instructions

### Étape 1 : Définir la requête cible

Demander à l'utilisateur :
1. **La requête principale** à cibler
2. **Le type d'intention** (transactionnelle, informationnelle, navigationnelle)
3. **Le niveau d'expertise** de l'audience cible

### Étape 2 : Générer le tableau des entités vectorielles

Adopter le rôle d'un ingénieur IA spécialisé en recherche vectorielle. Générer un tableau à 4 colonnes avec **10 termes/concepts par catégorie** :

| Entités Techniques (Vecteurs de base) | Preuves Quantitatives (Entités numériques) | Vecteurs Multimodaux | Éléments de Divergence (Haute Surprise) |
|---------------------------------------|-------------------------------------------|---------------------|----------------------------------------|
| Termes fondamentaux du champ lexical | Données chiffrées qui rassurent le Confidence Score | Formats attendus (images, outils, vidéos) | Concepts experts que 90% des concurrents oublient |

### Règles par catégorie

#### 1. Entités Techniques (Vecteurs de base)
Ce sont les termes **obligatoires** pour être considéré comme pertinent sur la requête.

Critères :
- Termes présents chez >80% des pages top 10
- Vocabulaire technique du domaine
- Synonymes et variations sémantiques
- Entités nommées pertinentes (marques, outils, standards)

#### 2. Preuves Quantitatives (Entités numériques)
Données chiffrées qui augmentent le **Confidence Score** de l'IA.

Critères :
- Statistiques de marché sourcées
- Benchmarks sectoriels
- Fourchettes de prix/délais/performances
- Données de comparaison (vs concurrence, vs moyenne)

Format : **[Chiffre] + [Unité] + [Contexte]**
- Exemple valide : "73% des entreprises B2B"
- Exemple valide : "ROI moyen de 4,2x sur 12 mois"
- À éviter : "beaucoup d'entreprises" (non quantifié)

#### 3. Vecteurs Multimodaux
Formats de contenu **attendus par l'intention** pour prouver l'expertise.

Types à considérer :
- **Images** : schémas, infographies, screenshots, avant/après
- **Outils interactifs** : calculateurs, simulateurs, générateurs
- **Vidéos** : tutoriels, témoignages, démonstrations
- **Tableaux** : comparatifs, tarifs, fonctionnalités
- **Téléchargeables** : templates, checklists, guides PDF

#### 4. Éléments de Divergence (Haute Surprise)
Concepts experts qui **forcent la mémorisation** du modèle IA.

Critères :
- Présent chez <10% des concurrents
- Requiert une expertise terrain réelle
- Apporte une valeur unique vérifiable
- Crée un "aha moment" chez le lecteur expert

**Test de divergence** : Si un concurrent peut facilement copier ce concept en 5 minutes, ce n'est PAS de la Haute Surprise.

### Étape 3 : Analyse du gap concurrentiel

Après le tableau, identifier :
1. **Entités manquantes** : ce que les concurrents ont et que vous n'avez pas
2. **Opportunités de divergence** : ce que personne n'a encore exploité
3. **Quick wins** : entités faciles à ajouter pour un gain rapide

### Étape 4 : Recommandations d'implémentation

Pour chaque catégorie, suggérer :
- Où placer ces entités dans la structure de page
- Comment les intégrer naturellement (pas de keyword stuffing)
- Les formats HTML recommandés (schema.org, tableaux, listes)

## Notes importantes

- Les entités doivent être intégrées naturellement, pas listées artificiellement
- Prioriser la qualité de l'intégration sur la quantité d'entités
- Mettre à jour régulièrement car les vecteurs évoluent avec les tendances
Brief éditorial
---
name: seo-brief-contenu
description: >
  Produire un brief de contenu SEO complet avec structure Hn optimisée pour le Passage Ranking.
  Basé sur les vecteurs sémantiques, micro-intentions et signaux E-E-A-T — sans copier les concurrents.

  TOUJOURS utiliser ce skill quand l'utilisateur mentionne : brief, structure Hn, plan de page,
  brief éditorial, architecture de contenu, "crée-moi un brief pour ce mot-clé",
  "comment structurer ma page sur [requête]", "quels H2 mettre dans cet article",
  "je veux rédiger sur X, donne-moi le plan", outline, squelette de page, hiérarchie de titres,
  ou demande un plan de rédaction SEO.
---

# Skill 03 — Brief de Contenu & Structure Hn

## Rôle

Produire un brief de contenu complet basé sur les vecteurs sémantiques de la requête, les micro-intentions détectées, et la logique du Passage Ranking — sans copier la structure des concurrents et sans jamais donner la base Hn à l'IA pour qu'elle rédige seule.

---

## Réflexion appliquée (méthode Organikk)

- La **structure Hn est la colonne vertébrale du ranking**. Un mauvais plan = un mauvais contenu, même bien rédigé.
- On ne regarde pas les concurrents pour copier leur structure — on les regarde pour **identifier ce qu'ils n'ont pas dit**.
- La structure doit être construite à partir des **vecteurs sémantiques et des micro-intentions**, pas à partir d'un prompt générique.
- Le brief est toujours **rédigé en premier par l'humain** (au moins les tirets et idées clés par H2). L'IA améliore, elle ne crée pas à partir de zéro.
- L'objectif **Fully Meets** impose de répondre à l'intention primaire ET aux sous-intentions — le plan doit couvrir les deux.
- Chaque H2 doit correspondre à un **vecteur sémantique attendu** par Google sur cette requête.
- La structure doit générer un **"Gradient de Surprise"** (High Surprise). Si les H2 se contentent d'énoncer des évidences, le contenu subira un "Weight Decay" (oubli adaptatif par l'IA). Un bon H2 apporte une information inattendue ou brise un pattern.

---

## Données requises

| Source | Description | Obligatoire |
|--------|-------------|-------------|
| Mot-clé principal | + cluster de requêtes associées (GSC ou outil) | Oui |
| Micro-intentions | Questions, sous-requêtes, FAQ patterns | Oui |
| Contexte E-E-A-T | Expériences client, cas concrets, données propriétaires | Recommandé |
| Type de page | Landing page service, article blog, page pilier | Recommandé |

**Minimum viable :** Mot-clé principal + intention de la page + secteur d'activité.

---

## Raisonnement de l'agent (étapes obligatoires)

### Étape 1 — Décoder la requête

Identifier l'intention primaire :

| Type | Signal | Objectif utilisateur |
|------|--------|---------------------|
| **Informationnelle** | comment, pourquoi, qu'est-ce que | Comprendre |
| **Transactionnelle** | acheter, prix, devis, urgence | Agir maintenant |
| **Navigationnelle** | [marque], [nom produit] | Trouver un site précis |
| **Décisionnelle** | meilleur, comparatif, avis, vs | Choisir avant d'agir |

Identifier les **intentions latentes** (ce que l'utilisateur ne formule pas mais cherche implicitement).

### Étape 2 — Lister les vecteurs sémantiques

Identifier les éléments attendus par Google sur cette requête :
- **Entités** (marques, normes, labels, lieux)
- **Co-occurrences** (termes qui apparaissent systématiquement avec le mot-clé)
- **Vocabulaire expert** du secteur (jargon technique légitime)

### Étape 3 — Identifier les micro-intentions

Questions que l'utilisateur se pose :
- **Avant** la décision (phase recherche)
- **Pendant** la décision (phase comparaison)
- **Après** la décision (phase action/validation)

### Étape 4 — Construire la structure Hn

```
H1 : Requête principale + différenciateur (donnée chiffrée ou angle unique)
│
├── H2 : [Vecteur sémantique 1] — Gradient de Surprise si possible
│   ├── H3 : Micro-intention A
│   └── H3 : Micro-intention B
│
├── H2 : [Vecteur sémantique 2]
│   └── H3 : Sous-angle technique
│
├── H2 : [Vecteur sémantique 3]
│
└── H2 : FAQ décisionnelle (questions bas de funnel)
    ├── H3 : Question 1
    ├── H3 : Question 2
    └── H3 : Question 3
```

**Règle du Gradient de Surprise :** Au moins 1 H2 doit apporter une information inattendue, contre-intuitive, ou que les concurrents évitent de mentionner.

### Étape 5 — Définir le contenu attendu par H2

Pour chaque H2, indiquer :
- Type de contenu (données chiffrées, FAQ, liste d'étapes, témoignage, tableau comparatif)
- Longueur indicative
- Éléments obligatoires

### Étape 6 — Identifier les signaux E-E-A-T à injecter

- **Experience** : cas clients réels, témoignages terrain
- **Expertise** : données propriétaires, méthodologie unique
- **Authoritativeness** : citations de sources reconnues, certifications
- **Trustworthiness** : transparence sur les limites, prix réels

### Étape 7 — Définir le format multimodal

Selon l'intention Fully Meets, identifier les formats requis :
- Vidéo démonstrative
- Tableau comparatif
- Calculateur/simulateur
- Schéma/infographie
- Template téléchargeable

**NE PAS répondre avant d'avoir complété chaque étape.**

---

## Format de sortie OBLIGATOIRE

```
BRIEF — '[Mot-clé principal]'

## Intention
- Primaire : [Type] — [Description]
- Latentes : [Liste]

## Vecteurs sémantiques clés
[Liste des entités, co-occurrences, vocabulaire expert]

## Structure Hn

H1 : [Titre optimisé avec différenciateur]

H2 : [Vecteur 1 — avec Gradient de Surprise si applicable]
  → Contenu attendu : [Type + éléments obligatoires]
  H3 : [Micro-intention]
  H3 : [Micro-intention]

H2 : [Vecteur 2]
  → Contenu attendu : [Type + éléments obligatoires]

H2 : [Vecteur 3]
  → Contenu attendu : [Type + éléments obligatoires]

H2 : FAQ décisionnelle
  H3 : [Question bas de funnel 1]
  H3 : [Question bas de funnel 2]
  H3 : [Question bas de funnel 3]

## Signaux E-E-A-T à injecter
- [Signal 1 + où l'insérer]
- [Signal 2 + où l'insérer]

## Format multimodal requis
- [Format 1 + justification]
- [Format 2 + justification]
```

---

## Exemple de sortie attendue

```
BRIEF — 'Remplacer batterie voiture électrique'

## Intention
- Primaire : Décisionnelle — l'utilisateur veut comprendre le coût et le process avant de choisir un prestataire
- Latentes : peur de l'arnaque, besoin de réassurance sur la durée de vie, question de la garantie

## Vecteurs sémantiques clés
prix, durée intervention, garantie, modèle (Tesla/Renault/Peugeot), autonomie après remplacement,
batterie reconditionnée vs neuve, aides ADEME, capacité kWh, dégradation normale

## Structure Hn

H1 : Remplacement batterie voiture électrique : prix réels, délais et ce que personne ne dit

H2 : [GRADIENT DE SURPRISE] L'erreur à 500€ que 90% des propriétaires font
  → Contenu attendu : Cas concret + piège à éviter + solution
  → Ce H2 brise le pattern "intro générique" et capte l'attention

H2 : Combien coûte réellement le remplacement ? (données 2024)
  → Contenu attendu : Tableau de prix par modèle, neuf vs reconditionné
  H3 : Prix batterie neuve par modèle (Tesla, Renault, Peugeot)
  H3 : Prix batterie reconditionnée — est-ce fiable ?
  H3 : Ce que votre assurance peut couvrir

H2 : Quand faut-il vraiment changer sa batterie ?
  → Contenu attendu : Tableau diagnostic avec seuils + signes d'alerte
  H3 : Les 4 signes qui ne trompent pas
  H3 : Différence entre dégradation normale et défaut

H2 : Trouver un prestataire fiable : les 3 critères que personne ne mentionne
  → Contenu attendu : Checklist actionnable + red flags

H2 : FAQ décisionnelle
  H3 : Puis-je rouler avec une batterie dégradée à 70% ?
  H3 : Le remplacement remet-il le compteur de garantie à zéro ?
  H3 : Batterie chinoise vs européenne : quelle différence réelle ?

## Signaux E-E-A-T à injecter
- 2 cas clients réels avec marque du véhicule + coût final + satisfaction (dans H2 prix)
- Mention certification/agrément du prestataire (dans H2 prestataire)
- Source ADEME pour les aides (dans H3 assurance)

## Format multimodal requis
- Calculateur de coût estimatif en haut de page (intention = "combien ça coûte")
- Tableau comparatif prix neuf/reconditionné par modèle (scannable)
```

---

## Ce que l'agent NE DOIT PAS faire

- Donner la base Hn complète à l'IA pour qu'elle rédige seule — la réflexion doit rester humaine
- Copier la structure des 3 premiers résultats Google — c'est la définition du contenu moyen
- Produire un plan générique sans identifier les vecteurs sémantiques réels de la requête
- Oublier les micro-intentions : un plan sans FAQ ou sous-angles est incomplet
- Ignorer le format multimodal : Google évalue si la page répond à l'intention avec le bon type de contenu
- Créer des H2 sans Gradient de Surprise — si tous les H2 sont prévisibles, le contenu sera oublié par les LLMs
- Proposer des H2 génériques comme "Introduction", "Conclusion", "Notre avis" — ce sont des vecteurs vides

---

## Critère de qualité

La sortie est **bonne** si :

1. Chaque H2 correspond à un **vecteur sémantique identifié** (pas un titre générique)
2. Le **Gradient de Surprise est présent** (au moins 1 H2 contre-intuitif ou différenciant)
3. La FAQ contient des **questions bas de funnel** (pas des questions génériques)
4. Le brief inclut **au moins 2 signaux E-E-A-T propriétaires** avec emplacement précis
5. Le **format multimodal est justifié** par l'intention de la requête
6. Aucun H2 générique ("Introduction", "Conclusion", "À retenir")
FAQ stratégique
---
name: seo-faq-query
description: >-
  Génère la FAQ stratégique d'une page, conçue comme un levier décisionnel et non comme du
  remplissage. Reverse engineering sémantique, diversité RRF (Reciprocal Rank Fusion), objectif
  Fully Meets : 5 à 7 questions maximum, chacune activant un vecteur sémantique unique, chaque
  réponse citable isolément et destinée au balisage FAQPage. Verrouillage strict de la
  perspective utilisateur (B2B ou B2C) et filtrage des questions qui n'aident pas à décider.
  TOUJOURS utiliser ce skill quand Tim dit : "/seo-faq-query", "fais la FAQ", "FAQ query",
  "ajoute une FAQ à cette page", "la FAQ de la page pilier", "questions FAQ RRF", "FAQPage
  schema", ou quand une page publiée n'a pas encore sa FAQ. La FAQ est obligatoire sur toute
  page publique : ne jamais en écrire une sans passer par ce skill.
---

# Skill — FAQ Query

## Contexte et rôle

Tu es expert SEO et ingénieur IA, spécialisé en reverse engineering sémantique, optimisation RRF
(Reciprocal Rank Fusion) et atteinte du score Fully Meets.

La FAQ d'une page pilier est un levier décisionnel. Elle couvre les micro-intentions latentes,
décisionnelles et transactionnelles, renforce la diversité RRF, et supprime le besoin d'une
requête secondaire critique. Une FAQ informative ou pédagogique est un échec.

## Entrées requises

| Entrée | Obligatoire | Exemple |
|---|---|---|
| Thème principal ou requête cible | Oui | « arrêter la cigarette mais pas le joint » |
| Perspective utilisateur : B2B ou B2C + rôle précis + contexte d'usage | Oui | B2C, fumeur qui consomme aussi du cannabis, cherche à arrêter le tabac seul |
| Objectif stratégique de la page | Oui | Lead gen / Conversion / Expertise Fully Meets |
| Corpus sourcé de la page | Oui sur un sujet à enjeu | fiches `raw/` déjà écrites |

Sans perspective utilisateur explicite, ne pas générer : la demander.

## Règles de filtrage, non négociables

Exclure toute question ou réponse qui :

- n'aide pas directement à une décision, une action ou une réduction de risque,
- ne contribue pas explicitement à l'atteinte du niveau Fully Meets,
- n'active pas un signal RRF distinct et mesurable.

### Verrouillage B2B / B2C

Exclure toute question ou réponse qui ne correspond pas strictement à la perspective définie.

- Perspective B2B : exclure le langage, les scénarios et la logique B2C (usage personnel,
  assurance individuelle, paiement particulier, confort domestique).
- Perspective B2C : exclure la logique B2B (retour sur investissement d'entreprise, process
  interne, contractualisation cadre, multi-sites, décision collective).

### Interdictions formelles

- Aucune redondance sémantique entre questions.
- Aucune question pédagogique ou générique.
- Aucune reformulation déguisée d'un même besoin.

En cas de conflit entre richesse sémantique et utilité business, privilégier toujours l'utilité
décisionnelle pour la perspective utilisateur.

## Tâche : déploiement RRF

Générer 5 à 7 questions maximum, destinées à un balisage `FAQPage`, avec une diversité sémantique
stricte. Chaque question active un vecteur sémantique unique du cluster.

Typologies à piocher selon la pertinence, jamais toutes systématiquement :

- **Transactionnelle** : coût, investissement, rentabilité.
- **Comparative ou décisionnelle** : choix de la solution adaptée au contexte utilisateur.
- **Implémentation** : process réel, point de friction opérationnel.
- **Risque ou conformité** : erreurs critiques, contraintes légales ou techniques.
- **Longue traîne experte** : spécificité élevée, E-E-A-T renforcé.
- **Définition avancée**, optionnelle, uniquement si une entité complexe bloque la décision.

## Exigences sur les réponses

Chaque réponse est :

- courte, précise, jamais générique,
- porteuse d'une information actionnable ou décisionnelle,
- construite pour lever explicitement une objection,
- rédigée avec un niveau d'autorité expert,
- citable isolément sans perte de contexte, prête pour une reprise en AI Overview.

## Format de sortie

Liste structurée, question par question. Pour chaque question, dans cet ordre :

1. la question,
2. la réponse,
3. une ligne distincte : **Vecteur sémantique couvert :** description concise du signal activé.

Aucun tableau. Aucun texte hors FAQ.

## Contrôles RRF avant livraison

- Aucun chevauchement sémantique entre deux questions.
- Un signal RRF distinct par question.
- La FAQ suffit à atteindre Fully Meets sans requête secondaire critique.

## Règles maison qui s'appliquent par-dessus

- **Une FAQ est toujours un accordéon, avec un signe plus à droite de chaque question.** Règle de
  design générale de Tim, valable sur tous ses sites : six réponses dépliées alourdissent la page
  pour rien. La question seule est visible, le plus ouvre la réponse. À construire avec `details`
  et `summary` natifs plutôt qu'avec du JavaScript : la réponse reste présente dans le HTML livré,
  donc lisible par un moteur et reprise dans le balisage `FAQPage`.
- **Style de la FAQ = style de la FAQ de la home du site concerné.** Ouvrir la home, reprendre le
  composant existant tel quel, mêmes classes, même markup, même comportement. Jamais de variante
  locale. Si le site n'a pas encore de FAQ sur sa home, le signaler à Tim : la première FAQ créée
  devient la référence, ce n'est pas un choix à faire en passant.
- Ton de voix du site, jamais un ton générique : sur un site qui a déjà des articles, aller y
  chercher le registre, notamment le tutoiement ou le vouvoiement.
- Aucune tournure de rédaction automatique : pas d'antithèse « ce n'est pas X, c'est Y », pas de
  mise en scène (« il faut savoir que »), pas de suspense, pas de tiret cadratin.
- Sur un sujet à enjeu (santé, droit, argent), chaque chiffre d'une réponse vient d'une source
  vérifiée du corpus, jamais de la connaissance générale du modèle. Une question sans source
  disponible est écartée, pas comblée.
- Mots bannis de Tim : jamais « gains rapides », « territoire », « concurrent », « lien mort »,
  « Money Page », ni tiret cadratin.

## Enchaînement

En amont : `seo-clustering-mots-cles` pour connaître le cluster de la page, `seo-mots-cles-decisionnels`
pour repérer les intentions Do. En aval : `seo-donnees-structurees` pour le balisage `FAQPage`,
`seo-needs-met-rrf` pour l'évaluation du résultat.
Données structurées
---
name: seo-donnees-structurees
description: >
  Mise en place de données structurées JSON-LD automatiques sur un site Next.js
  (App Router) : graphe d'entité site-wide unique référencé par @id, et schémas
  par page DÉRIVÉS du contenu (Article, FAQPage, HowTo, VideoObject,
  BreadcrumbList) sans saisie manuelle. Généralisé à partir du système en
  production sur organikk-next (src/lib/schema.ts).

  TOUJOURS utiliser ce skill quand l'utilisateur dit : "données structurées",
  "schema.org", "JSON-LD", "rich results", "rich snippets", "balisage",
  "FAQPage", "HowTo schema", "BreadcrumbList", "VideoObject", "entité Google",
  "knowledge graph du site", "@id graph", ou demande d'ajouter, refondre ou
  auditer le balisage structuré d'un site (en priorité Next.js App Router).
---

# Skill — Données structurées JSON-LD automatiques

## Quand déclencher

Ajouter, refondre ou auditer le balisage structuré d'un site. Objectif : éligibilité aux rich results Google ET consolidation d'une entité unique exploitable par les moteurs de réponse (AEO). Pas du schema décoratif, du schema qui sert le Grounding et la citation.

## Principe non-négociable

Trois règles, dans cet ordre. Si l'une saute, le skill a échoué.

1. **Source unique.** Tout le JSON-LD vient d'un seul module (`lib/schema.ts`). Aucun bloc schema écrit en dur dans une page.
2. **Une entité, référencée par `@id`.** Le graphe site-wide (Organization, WebSite, Person) est émis une seule fois dans le layout racine. Chaque page de contenu pointe vers ces nœuds par `@id` (author / publisher / isPartOf), elle ne redéclare jamais l'auteur ni l'éditeur. Google fusionne tous les blocs d'une page et consolide une seule entité. C'est ça qui construit le knowledge graph du site, pas la répétition.
3. **Le schema est dérivé du contenu, jamais saisi à la main.** Un champ schema qui n'est pas calculé depuis la donnée de la page est une dette : il se désynchronise au premier edit. Si on doit le taper deux fois, c'est cassé.

## Architecture de référence

Graphe site-wide (`siteGraph()`, émis dans le layout racine) :

- `Organization` (+ `ProfessionalService` si activité de service) avec `@id = {SITE_URL}/#organization`
- `WebSite` avec `@id = {SITE_URL}/#website`, `publisher` -> ref Organization
- `Person` (fondateur / auteur) avec `@id = {SITE_URL}/#person-...`, `worksFor` -> ref Organization
- `ImageObject` logo avec `@id = {SITE_URL}/#logo`, partagé par `logo` et `image`
- `sameAs` : profils sociaux réels (LinkedIn, YouTube, X, Substack). Pas d'URL inventée.

Refs légères exportées et réutilisées partout : `AUTHOR_REF = {'@id': PERSON_ID}`, `PUBLISHER_REF = {'@id': ORG_ID}`, `WEBSITE_REF = {'@id': WEBSITE_ID}`.

## Règle de dérivation automatique (le cœur du skill)

Chaque type de schema se déduit d'un signal présent dans la donnée de la page. Tableau de correspondance à appliquer :

| Signal dans le contenu | Schema émis | Dérivation |
|---|---|---|
| Toute page article / post | `Article` ou `BlogPosting` | titre, excerpt, date, section ; `wordCount` calculé par `countWords()` ; `keywords` depuis les highlights ; author/publisher/isPartOf = refs |
| Toute page (toujours) | `BreadcrumbList` | `breadcrumb()` à partir du chemin (Accueil > rubrique > titre) |
| Bloc `faq` présent dans les sections | `FAQPage` | `mainEntity` = map des items q/a en Question/Answer. Zéro saisie |
| Section `video` présente | `VideoObject` | ID YouTube extrait par regex de l'URL ; thumbnail + embedUrl déduits |
| H2 dont le titre matche un prédicat (ex. contient "prompt", "étapes", "tutoriel") | `HowTo` | collecte les H3 numérotés suivants + leur contenu (p / code / listes) en `HowToStep` |
| Page produit / offre avec prix | `Product` / `Offer` | depuis les champs prix/dispo de la donnée. Jamais de prix inventé |

Principe : on ne demande jamais à l'utilisateur "quel schema veux-tu". On lit la structure de la page et on émet ce que la structure prouve. Un schema sans preuve dans le contenu = suppression.

## Procédure

1. **Détecter le terrain.** Framework et version. Si Next.js : App Router ou Pages ? Lire la doc du projet (sur organikk-next : `node_modules/next/dist/docs/`, conventions imposées par AGENTS.md) avant d'écrire une ligne. Ne jamais présumer l'API metadata.
2. **Cartographier le modèle de données.** Où vivent les articles, pages, FAQ, vidéos (ex. `src/data/*.ts`). Identifier la forme des sections (le schema se dérive de là).
3. **Créer / refondre `lib/schema.ts`** : config d'identité en tête (SITE_URL, identité Organization/Person/sociaux), les nœuds, `siteGraph()`, les refs `@id`, les helpers `breadcrumb()` et `countWords()`. Partir de `references/schema-reference.ts`.
4. **Câbler le layout racine** : un seul `<script type="application/ld+json">` avec `siteGraph()`.
5. **Câbler chaque template de contenu** : construire un tableau `jsonLd[]` (Article + breadcrumb toujours, puis FAQ / Video / HowTo conditionnels selon les signaux), sérialisé dans UN script en tête de page.
6. **Dédupliquer.** Supprimer tout ancien bloc Organization/Person redéclaré dans les pages : tout passe par les refs `@id`.
7. **Valider** (voir checklist). Corriger jusqu'à zéro erreur.

## Émission

- Site-wide : un `<script type="application/ld+json">` dans le layout racine, contenu = `siteGraph()`.
- Par page : un seul `<script type="application/ld+json">` en tête, contenu = `JSON.stringify(jsonLd)` où `jsonLd` est le tableau des nœuds de la page.
- App Router : injection via `dangerouslySetInnerHTML` dans un Server Component. Ne pas utiliser de lib tierce, ce sont des objets JS purs.

## Validation (checklist, zéro erreur tolérée)

- [ ] Chaque `@id` site-wide est unique et stable, réutilisé par ref dans les pages
- [ ] Aucune page ne redéclare un nœud Organization ou Person en entier
- [ ] `Article` : headline non vide, `datePublished` valide, `wordCount` calculé (pas codé en dur), author/publisher en ref
- [ ] `FAQPage` émis seulement si un vrai bloc FAQ existe, et chaque réponse est du texte réel
- [ ] `HowTo` émis seulement si des étapes ordonnées existent réellement
- [ ] `VideoObject` : `contentUrl`/`embedUrl` résolus, thumbnail valide
- [ ] `BreadcrumbList` cohérent avec l'URL réelle
- [ ] JSON-LD valide et passe le test Rich Results de Google + le validateur schema.org
- [ ] Aucun champ inventé (prix, note, avis, premier sur X) sans preuve : un faux signal dégrade la note Google de la page

## Anti-patterns (à ne jamais faire)

- Redéclarer l'auteur et l'éditeur sur chaque page au lieu de référencer par `@id`
- Écrire du JSON-LD en dur dans le JSX d'une page
- Émettre un `FAQPage` ou `HowTo` "au cas où" sans contenu correspondant visible sur la page (risque de pénalité, et c'est du mensonge à Google)
- Mettre `aggregateRating` / `Review` / prix non vérifiables
- Multiplier les `<script ld+json>` redondants au lieu d'un tableau unique par page
- Hardcoder `wordCount`, des dates ou des compteurs au lieu de les dériver de la donnée
- Présumer l'API Next.js sans lire la doc de la version du projet

## Référence d'implémentation

`references/schema-reference.ts` : module généralisé prêt à adapter (config d'identité en tête, nœuds, `siteGraph`, refs `@id`, `breadcrumb`, `countWords`, builders `articleSchema` / `faqSchema` / `videoSchema` / `howToFromSections`). C'est la version dé-Organikk-isée du système en production sur `organikk-next/src/lib/schema.ts`. L'adapter au modèle de données du site cible, ne pas le copier tel quel.

## Concepts liés

`aeo` · `grounding-score` · `entites-vectorielles` · `passage-ranking` · `knowledge-graph` · `e-e-a-t`
Architecture de maillage
---
name: maillage-systeme
description: >
  Maillage interne stratégique d'un site (blog, catalogue, doc) : architecture en piliers,
  classification hub/satellite, sélection d'ancres avec diversification entrante,
  détection des pages orphelines et dead-end, audit complet du graphe interne.

  Complémentaire au skill maillage-interne-gsc qui exploite la donnée Search Console.
  Celui-ci raisonne sur la structure éditoriale et le contenu, sans dépendre de la GSC.
  Utilisable dès la phase de cadrage d'un nouveau site, avant qu'aucune donnée
  comportementale ne soit disponible.

  TOUJOURS utiliser ce skill quand l'utilisateur mentionne : architecture de maillage,
  piliers de blog, hub et satellite, ancres internes, anchor text, choix d'ancre, audit
  maillage interne, orphan pages, pages dead-end, link equity, structurer le maillage
  d'un nouveau site, mailler un blog avant lancement, plan de cocon, ou uploade
  une liste d'articles/URLs et veut un plan de maillage complet.
---

# Skill — Maillage Interne : Architecture, Ancres et Audit

## Rôle

Construire et auditer le graphe de liens internes d'un site à partir du contenu existant ou planifié, sans dépendre de la Search Console. Le skill produit trois livrables : une **architecture en piliers**, un **plan d'ancres diversifiées** par lien, et un **rapport d'audit** des trous structurels.

L'objectif n'est pas de générer des liens à la chaîne. C'est de construire un graphe où chaque lien est justifié par trois signaux : topique, intention et autorité.

---

## Réflexion appliquée (méthode Boussardon)

- Le maillage interne est **un système, pas une passe**. Trois axes simultanés : topique, intention, autorité.
- Une ancre, ce n'est pas un mot-clé. C'est **une promesse de continuité** entre deux pages, lue par Google, par les LLM (en vecteur), et par l'humain (en désir de cliquer).
- **5 ancres possibles vers la même page = 5 ancres différentes.** Un seul exact match. Le reste est partial / sémantique / contextuel long.
- **Test à voix haute** : si la phrase tombe juste sans le lien, l'ancre est bien intégrée. Si elle clopine, l'ancre est plaquée.
- **Le maillage Know→Do passe avant le maillage Know→Know.** Une page qui explique un concept doit toujours pointer vers la page qui permet de l'exécuter (outil, audit, démo).
- **Pas de "Voir aussi" en bas d'article.** Le contexte de lien est dilué. Liens contextuels in-body uniquement.
- **Une page mère n'est pas un titre de catégorie.** C'est l'article le plus stratégique du pilier, celui qui définit le vocabulaire et reçoit le plus de liens internes.
- **Le cross-pillar pollination compte autant que le maillage intra-cluster.** 1 lien sortant sur N doit pointer vers un autre pilier pour éviter la siloïsation.

---

## Données requises

| Source | Description | Obligatoire |
|--------|-------------|-------------|
| Liste des URLs/articles | Titre, slug, catégorie, excerpt, mots-clés cibles | Oui |
| Contenu intégral (markdown ou HTML) | Pour détecter les opportunités contextuelles | Recommandé |
| Mots-clés piliers (3-5) | Le vocabulaire métier business du client | Recommandé |
| Pages "Do" identifiées | URLs des outils, audits, formulaires, simulateurs | Recommandé |

**Minimum viable** : la liste des articles avec titre + excerpt + mots-clés. Sans le contenu intégral, le skill produit l'architecture mais pas les ancres précises.

---

## Étape 0 — Ingestion (site existant en ligne)

**Règle de contexte : le contenu intégral du site n'entre JAMAIS d'un bloc dans le contexte principal.** La qualité de raisonnement d'un LLM se dégrade quand la fenêtre se remplit ; charger 50+ pages HTML avant de raisonner produit un plan médiocre. Le contexte principal ne travaille que sur l'index.

Si le site est en ligne avec un sitemap, lancer le script d'ingestion AVANT toute lecture de page :

```bash
python3 ~/.claude/skills/maillage-systeme/scripts/crawl_graph.py https://site.com/sitemap.xml -o ./maillage-data
```

Le script (stdlib Python uniquement, zéro dépendance, zéro token) produit :

- **`index.json`** — une ligne légère par page : URL, title, H1, meta description, compteurs inbound/outbound éditoriaux, listes des orphelines et dead-ends. C'est le SEUL fichier chargé dans le contexte principal.
- **`graph.json`** — tous les liens internes avec leur ancre exacte, marqués `in_body` (hors nav/header/footer/aside) et `sitewide` (même couple cible+ancre présent sur ≥ 80 % des pages = lien de gabarit, exclu du comptage éditorial même si le HTML n'est pas sémantique).

Répartition du travail ensuite :

1. **Étapes 1-4 et 6-7** raisonnent sur `index.json` + les compteurs de `graph.json`. Pas de lecture de contenu.
2. **Étape 5 (ancres précises)** : déléguer à des sous-agents. Chaque sous-agent lit 2-3 pages sources maximum, propose les passages et ancres, seul le résultat remonte au contexte principal.
3. Les ancres existantes vers une cible (pour la diversification) se lisent dans `graph.json`, jamais en re-crawlant.

Si le site n'est pas en ligne (contenu planifié, markdown local), sauter cette étape : la liste fournie par l'utilisateur fait office d'index, et la cartographie étape 4 se fait par parsing des fichiers locaux (grep des liens, pas lecture intégrale en contexte).

---

## Raisonnement de l'agent (étapes obligatoires)

L'agent DOIT suivre ces étapes **dans l'ordre** avant de répondre.

### Étape 1 — Classifier chaque page en intention

Pour chaque article, déterminer son intention dominante :

| Intention | Description | Exemples de signaux |
|-----------|-------------|---------------------|
| **Know-Simple** | Définition courte, réponse directe | titre commence par "Qu'est-ce que", "C'est quoi" |
| **Know** | Guide approfondi, méthode, comparatif | titre "Comment", "Pourquoi", "Guide" |
| **Do** | Outil, simulateur, formulaire, démo | URL contient `/outils/`, `/audit`, `/contact` |

Une page peut avoir une intention dominante + une intention secondaire. Noter les deux.

### Étape 2 — Identifier les piliers

Regrouper les articles par cohérence sémantique (pas par catégorie technique). Cibler **3 à 5 piliers max**. Pas plus. Pas moins de 3.

Critères pour qu'un cluster forme un vrai pilier :
- Au moins 3 articles dans le cluster
- Un mot-clé business central qui revient dans tous les titres ou excerpts
- Une page-hub naturelle : l'article le plus complet ou le plus stratégique du cluster

Si un cluster a moins de 3 articles, il devient un **sous-cluster** d'un pilier existant, pas un pilier indépendant.

### Étape 3 — Désigner le hub de chaque pilier

Pour chaque pilier, identifier la page-hub :
- Article le plus complet (ou prévu pour l'être)
- Recouvre les concepts secondaires des autres articles du pilier
- Idéalement : positionné sur le mot-clé pilier exact

Le hub reçoit des liens entrants depuis tous les satellites. Le hub redistribue vers les satellites via des liens contextuels (pas une liste).

### Étape 4 — Cartographier les liens existants

Si l'étape 0 a tourné, cette cartographie est DÉJÀ dans `index.json` (compteurs) et `graph.json` (détail des ancres) : la lire, pas la refaire. Sinon, pour chaque article, lister :
- **Inbound links** : combien d'articles pointent vers lui ?
- **Outbound links** : vers combien d'articles pointe-t-il ?

(La profondeur de clic n'est PAS un critère : on ne la mesure pas, on ne la corrige pas.)

Détecter les anomalies :
- **Orphan pages** : 0 inbound link
- **Dead-end pages** : 0 outbound link
- **Hub sous-maillé** : moins de 5 inbound depuis ses satellites

### Étape 5 — Sélectionner les ancres pour chaque lien proposé

Pour chaque lien `Source → Cible` à créer, produire **3 propositions d'ancres** classées :

1. **Exact match** (1 max par cible, sur la première mention) : reproduit le mot-clé pilier exact de la cible
2. **Partial match** (60-70% des liens entrants vers une cible) : variation autour du mot-clé pilier
3. **Sémantique étendue** : reformule la promesse de la cible sans utiliser le mot-clé

Pour chaque ancre, vérifier les 5 critères :

| Critère | Question à se poser |
|---------|---------------------|
| Promesse de la cible | L'ancre reflète-t-elle ce que l'utilisateur va trouver, pas le titre H1 ? |
| Phrase porteuse | La phrase reste-t-elle fluide à voix haute sans le lien ? |
| Diversification | Cette ancre est-elle déjà utilisée vers la même cible depuis une autre page ? |
| Position | L'ancre porte-t-elle le verbe d'action ou le substantif central, pas un mot de liaison ? |
| Link context | Les 5 mots avant/après parlent-ils du sujet de la cible ? |

Si une ancre rate un critère, la rejeter.

### Étape 6 — Prioriser les liens à créer

Score d'urgence par lien proposé :
**Score = (impressions cible × poids_intention) + (gain_authority × 0.4)**

Où :
- `poids_intention` : Do = 1.0, Know-décisionnel = 0.8, Know = 0.5, Know-Simple = 0.3
- `gain_authority` : 1 si la source est un hub, 0.5 si la source est un satellite mailé, 0.2 sinon

Prioriser dans cet ordre :
1. **Liens manquants Hub → Satellite** dans un pilier (pour activer le cocon)
2. **Liens Know → Do** (pour orienter le funnel)
3. **Liens cross-pillar** (1 par pilier minimum vers un autre pilier)
4. **Liens vers pages orphelines** identifiées en étape 4

### Étape 7 — Vérifier les règles de conservation

Avant de finaliser le plan, valider :
- Aucune page orpheline restante (chaque page reçoit ≥ 1 inbound)
- Aucune page dead-end (chaque page contient ≥ 2 outbound)
- Chaque hub reçoit ≥ 5 inbound depuis ses satellites
- Aucune cible ne reçoit la même ancre 2 fois
- Densité raisonnable : 2 à 5 liens internes par 1000 mots, jamais plus

**NE PAS répondre avant d'avoir complété chaque étape.**

---

## Format de sortie OBLIGATOIRE

### Bloc 1 — Architecture détectée

```
PILIER 1 — [Nom thématique] (mot-clé pilier : "...")
├── HUB : [titre article + slug]
├── Satellite : [titre + slug] (intention : Know)
├── Satellite : [titre + slug] (intention : Know)
└── Satellite : [titre + slug] (intention : Do)

PILIER 2 — [Nom]
...
```

### Bloc 2 — Audit du graphe existant

Tableau :

| Article | Inbound | Outbound | Statut |
|---------|---------|----------|--------|
| ... | 3 | 4 | OK |
| ... | 0 | 2 | **ORPHELINE** |
| ... | 5 | 0 | **DEAD-END** |

### Bloc 3 — Plan de liens à créer (priorisé)

Pour chaque lien proposé :

```
PRIORITÉ : HAUTE | Score : 8.4
─────────────────────────────────
SOURCE     : [titre article source] (Know)
CIBLE      : [titre article cible] (Do)
PILIER     : Cross-pillar (Pilier 1 → Pilier 3)
NATURE     : Know → Do (orientation funnel)

PASSAGE PROPOSÉ :
"[Phrase complète où insérer le lien, en montrant les mots avant/après]"

ANCRES PROPOSÉES (choisir 1) :
  [exact]    "mot-clé pilier exact"
  [partial]  "variation naturelle du mot-clé"
  [sémant.]  "reformulation de la promesse cible"

JUSTIFICATION : [1 phrase sur pourquoi ce lien crée de la valeur]
```

### Bloc 4 — Règles de gouvernance

Une checklist finale que le client suit à chaque nouvelle publication :

- [ ] Le nouvel article reçoit ≥ 3 liens entrants depuis 3 articles existants
- [ ] Le nouvel article contient ≥ 3 liens sortants vers des articles existants
- [ ] Au moins 1 lien sortant pointe vers une page Do
- [ ] Au moins 1 lien sortant pointe vers un autre pilier (cross-pollination)
- [ ] Aucune ancre exacte n'est dupliquée vers la même cible
- [ ] Tous les liens sont in-body, aucun en bloc "Voir aussi"

---

## Points de vigilance

- **Ne pas tout automatiser.** Le skill propose, l'humain décide. Une ancre forcée détruit le naturel d'un texte.
- **Le contexte vaut plus que l'ancre.** Une ancre parfaite dans une phrase qui parle d'autre chose = lien faible. Réécris la phrase.
- **Le hub n'est pas figé.** Si un nouveau satellite devient plus complet que le hub historique, on bascule le hub. La structure suit le contenu, pas l'inverse.
- **Cross-pillar ≠ liens hors-sujet.** Le pont entre deux piliers doit reposer sur une vraie passerelle conceptuelle (pas "j'avais besoin d'un lien").
- **Ne jamais lier vers la home depuis le contenu.** La home a déjà tout le PageRank, elle n'en a pas besoin. Garde le jus pour les pages business.
- **Les FAQ sont une mine d'ancres.** Chaque réponse de FAQ qui mentionne un sous-sujet déjà traité doit lier. Densité haute, contexte naturel.
- **Densité plafonnée.** Au-delà de 5 liens internes pour 1000 mots, la dilution s'installe. Google pondère chaque ancre par 1/N où N est le nombre total de liens.

---

## Cas particulier — Site sans donnée GSC

Si le site est nouveau (moins de 3 mois ou pas d'accès GSC) :
- Étape 4 (cartographie inbound/outbound) se fait via l'étape 0 (script) si le site est en ligne, sinon par parsing du contenu local (markdown/HTML)
- Étape 6 (scoring) utilise un proxy : `position_business` (1 si Do, 0.7 si Know-décisionnel, 0.5 si Know, 0.3 si Know-Simple) au lieu d'impressions GSC
- Le plan reste valable, ajusté avec la GSC dès que la donnée arrive

---

## Cas particulier — Refonte de site existant

Si le site existe et a ≥ 6 mois de GSC :
- Chaîner ce skill avec **maillage-interne-gsc** : ce skill définit l'architecture, l'autre injecte la donnée comportementale
- Identifier les pages qui rankent déjà sur le pilier et les promouvoir hub si pertinent
- Préserver les liens existants qui marchent (pas de refonte aveugle)

---

## Cas particulier — Pages générées en masse depuis une table de données

Ce skill raisonne par lecture et jugement éditorial (étapes 1-7). Ce raisonnement suppose un nombre de pages qu'un agent peut encore comparer entre elles de façon cohérente. Il ne tient plus au-delà de quelques centaines de pages issues d'un même gabarit.

**Détection** : si un lot de pages partage la même route/le même template et provient d'une table de données (pSEO — un mot de lexique, une fiche produit, un lieu, une entité par ligne), et que ce lot dépasse **300-500 instances**, NE PAS appliquer les étapes 1-7 à ce lot. Le pilier de ces pages est déjà donné par le template lui-même — il n'y a rien à clusteriser.

**Ce qui remplace le raisonnement agent à cette échelle** : un signal de données réel et vérifiable, calculé une fois pour tout le lot, jamais un agent qui juge page par page. Par ordre de préférence :
1. **Relation déjà présente dans la donnée** (cooccurrence, attribut partagé, référence croisée, clé étrangère). C'est le signal le plus fiable : il est vérifiable, pas juste "sémantiquement proche". Exemple réel : sur bxble (13 622 pages `/lexique`, une par mot hébreu/grec), les "mots liés" de chaque page sortent d'un comptage de cooccurrence dans le corpus (`scripts/lexicon/build.mjs`), pas d'un embedding ni d'un agent.
2. **Embedding + kNN**, seulement si aucune relation de données n'existe pour rapprocher les instances entre elles.

Dans les deux cas, l'agent n'intervient qu'en amont — pour définir la règle (quel signal, combien de liens, quel format de rendu) — jamais par page. Le rendu est un bloc templaté (type "Mots liés"), pas un lien in-body : la règle "pas de Voir aussi" de ce skill vise le contenu éditorial écrit à la main, elle ne s'applique pas à un gabarit généré à grande échelle où aucune prose organique n'existe pour y glisser un lien contextuel.

Si le lot reste sous le seuil (quelques dizaines à ~300 pages), les étapes 1-7 s'appliquent normalement : à cette échelle, le jugement éditorial reste fiable et moins coûteux à mettre en place qu'un pipeline de données dédié.

---

## Rappels méthode

> "Le maillage interne, c'est un système, pas une passe."
> "5 liens entrants vers la même page = 5 ancres différentes. Un seul exact match."
> "Test à voix haute : si la phrase tombe juste sans le lien, l'ancre est bonne."
> "Une page Know doit toujours pointer vers une page Do."
> "Pas de Voir aussi. Liens in-body uniquement."
> "Un hub n'est pas une catégorie. C'est l'article le plus stratégique du pilier."
> "Le contexte des 5 mots avant/après l'ancre vaut plus que l'ancre elle-même."
Maillage par la Search Console
---
name: maillage-interne-gsc
description: |
  Analyse et optimisation du maillage interne depuis les données GSC. Hiérarchie page mère/fille/petite-fille selon la méthode Boussardon. Pipeline en 5 étapes : récupérer GSC → diagnostiquer la structure (mères potentielles, sous-maillées, orphelines) → construire le plan de maillage avec règles Know→Do → prioriser par score urgence → générer recommandations (page source, destination, ancre, contexte).

  TOUJOURS utiliser ce skill quand l'utilisateur dit : "maillage interne", "liens internes", "cocon SEO", "pages orphelines", "GSC + structure de site", quand un fichier GSC est uploadé.
---

# Skill — Maillage Interne GSC

## Quand déclencher

Analyse et optimisation du maillage interne depuis les données GSC. Hiérarchie page mère/fille/petite-fille.

## Philosophie

> "Le maillage interne, c'est la puissance. Et ça part de tes mots-clés."

- Page mère = au moins 5 citations depuis des pages filles/petites-filles
- Le maillage part de la stratégie de mots-clés → le cocon est la conséquence
- Priorité : transactionnel > décisionnel > informationnel
- Maillage par intention (Know → Do) en plus du maillage sémantique

## Input requis

| Source | Obligatoire |
|--------|-------------|
| Export GSC Pages — URL, Clics, Impressions, CTR, Position | Oui |
| Export GSC Requêtes par page | Recommandé |
| Période 3-6 mois | Recommandé |

## Pipeline (5 étapes)

1. **Récupérer les données GSC** — export Pages + Requêtes par URL
2. **Diagnostiquer la structure** :
   - Pages mères potentielles (impressions élevées, pos 4-15, requête transactionnelle)
   - Pages sous-maillées (bonne position mais CTR faible)
   - Pages orphelines (aucune thématique secondaire dans GSC)
3. **Construire le plan de maillage** — hiérarchie mère/fille/petite-fille + règles Know→Do
4. **Prioriser** — score urgence = (Impressions × 0.4) + (Potentiel position × 0.4) + (Business value × 0.2)
5. **Générer les recommandations** — page source + page destination + ancre + contexte + priorité

## Structure hiérarchique

```
Page Mère (mot-clé principal business)
├── Page Fille 1 (requête secondaire transactionnelle)
│   ├── Page Petite-Fille A (longue traîne / micro-intention)
│   └── Page Petite-Fille B
└── Page Fille 2
```

Règle Know → Do : chaque page Know doit pointer vers au moins 1 page Do thématiquement reliée.

## Output obligatoire

Pour chaque action :
- Page source (intention Know/Do/Know+Do)
- Page destination + intention
- Nature du lien (sémantique ou intentionnel Know→Do)
- Ancre recommandée (jamais "cliquez ici")
- Contexte d'insertion
- Priorité (Haute/Moyenne/Faible)

## Règles absolues

- Ne pas automatiser à 100% — le maillage part de la stratégie, pas des outils
- Ne pas mailler sans tenir compte de l'intention (sémantique ≠ intentionnel)
- Ne pas répéter la même ancre sur toutes les pages filles
- 10 citations minimum pour une page mère "active"

## Sauvegarde

Output dans `wiki/maillage/YYYY-MM-DD-slug.md` selon hook §7 AGENTS.md.

## Concepts liés

`cocon-semantique` · `pagerank-interne` · `intention-recherche` · `cannibalisation` · `gsc-export`


## Phase apprentissage (boucle)

Cette phase tourne APRES la production. Elle ne change jamais le code du skill toute seule.

1. **Briefing memoire** (debut de run, AVANT de produire) : lire `/Users/timothee/Code/seo-kb/loops/maillage-interne-gsc/manifest.yml` puis
   `/Users/timothee/Code/seo-kb/loops/maillage-interne-gsc/memory/` (directives, score-grid, wording_rules, questions) et `/Users/timothee/Code/seo-kb/loops/maillage-interne-gsc/ledgers/said_index.jsonl`
   pour ne pas repeter un angle deja couvert.

2. **Production** : faire le travail du skill normalement, en appliquant directives + score-grid.

3. **Ledger date** (append-only, jamais reecrire) dans `/Users/timothee/Code/seo-kb/loops/maillage-interne-gsc/ledgers/` :
   - `runs.jsonl` : 1 ligne {date, ce qui a ete produit, `capture_mode`: "native"}.
   - `claims.jsonl` : 1 ligne par fait/chiffre, avec sources (>=2 dont 1 primaire) et `capture_mode`.
   - `predictions.jsonl` : si le run produit du mesurable, 1 pari date {id, enonce, `resolve_by`: AAAA-MM-JJ (J+30 ou J+90)}.
   - `said_index.jsonl` : angles/sujets couverts ce run.
   - `mistakes.jsonl` : ce qui a sous-performe (rempli a la resolution, pas a la prod).

4. **Gate** : lancer `../_loop-kit/validate.sh /Users/timothee/Code/seo-kb/loops/maillage-interne-gsc` (ou `./validate.sh`). Si echec : corriger, ne pas commit.
   Optionnel : `../_loop-kit/eval_health.py /Users/timothee/Code/seo-kb/loops/maillage-interne-gsc` pour le signal OK / WATCH / ESCALATE.

5. **Propositions de code** : si la boucle "voudrait" changer le skill (nouvelle regle, seuil, formulation),
   elle NE le fait pas. Elle ecrit le diff propose + la raison dans `/Users/timothee/Code/seo-kb/loops/maillage-interne-gsc/memory/questions.md`. Tim tranche a la revue.

Regle d'or : **autonome sur la data, supervise sur le code.**
SEO programmatique
---
name: seo-programmatique-pseo
description: |
  Concevoir des stratégies de contenu programmatique SEO (pSEO) complètes : identifier des modèles de pages scalables où UN SEUL TEMPLATE + UNE VARIABLE = des centaines/milliers de pages uniques qui rankent chacune sur un mot-clé longue traîne. Génère l'architecture, les templates, la matrice de priorisation, les mots-clés et le plan d'exécution 90 jours.

  TOUJOURS utiliser ce skill quand l'utilisateur mentionne : programmatic SEO, pSEO, SEO programmatique, pages scalables, template + variable, génération de pages automatiques, "créer des centaines de pages", contenu programmatique, machine à trafic, base de données + SEO, landing pages dynamiques, longue traîne à grande échelle, "comment scaler mon contenu SEO", pages générées depuis une base de données, growth engineering SEO, ou veut transformer des données structurées en pages organiques.
---

# SEO Programmatique (pSEO) — Stratégie de Contenu Scalable

Ce skill conçoit des systèmes de contenu programmatique qui transforment des bases de données en machines à trafic organique. Il raisonne comme un ingénieur produit (data → template → pages) ET comme un SEO senior (intent → SERP → conversion).

## Quand utiliser ce skill

- Pour concevoir une stratégie pSEO complète à partir de données structurées
- Pour identifier des modèles de pages scalables (template + variable)
- Pour prioriser les modèles par effort, impact SEO et potentiel de conversion
- Pour générer les mots-clés longue traîne associés à chaque modèle
- Pour planifier l'exécution technique sur 90 jours

## Informations requises du client

Avant de commencer, collecter TOUTES ces informations. Si le client ne les fournit pas, les demander explicitement :

### Contexte du site
- **URL** : URL complète du site
- **Description** : ce que fait l'entreprise, pour qui, quelle offre principale, quel positionnement, quelle preuve sociale (avis, certifications, résultats) — 3 à 5 phrases

### Données disponibles en base
C'est le **carburant** du programmatique — sans données, pas de pages scalables. Lister TOUTES les données structurées que le site possède déjà ou peut générer :
- Base d'articles de blog (nombre, thématiques couvertes)
- Catalogue produits avec caractéristiques
- Base clients / cas d'étude par secteur
- FAQ exhaustive
- Données réglementaires, listes officielles, annuaires
- Données sectorielles, statistiques marché
- Clusters sémantiques déjà identifiés
- Toute autre source de données structurées

### Pages existantes
- Pages piliers (URLs + description courte)
- Pages services (URLs + description courte)
- Hub contenu / blog (URLs + description courte)
- Pattern d'URL du blog (ex: site.com/blog/[categorie]/[article])

### Concurrents directs
- 3 à 5 concurrents avec nom + positionnement en 1 phrase

### Objectifs business
- **Objectif primaire** : leads qualifiés, ventes, inscriptions, demandes de devis…
- **Objectif secondaire** : notoriété, vente produit complémentaire…
- **Cible principale** : persona #1 (qui est-il, quel problème, où dans son parcours)
- **Cible secondaire** : persona #2 si pertinent

### Contraintes
- Exclusions : axes à ne PAS traiter
- Cible précise : qui elle est, qui elle n'est PAS
- Ton souhaité : expert mais accessible, technique et précis, chaleureux…

## Processus de génération

### ÉTAPE 1 — Identifier les modèles scalables (minimum 5)

Pour chaque modèle, détailler :

#### A) Architecture
- **Nom du modèle**
- **Pattern d'URL** : [site.com]/[prefixe]/[variable]
- **Head term** (partie fixe) + **Modificateur** (variable qui change)
- **Nombre de pages possibles** (estimation réaliste)
- **Source de données** : quelle table/API/dataset alimente la variable

#### B) Template de page (structure exacte)
- **H1** : formule avec variable
- **Section par section** : contenu de chaque bloc (nombre de mots indicatif)
- **Données affichées vs données cachées** (teaser → conversion)
- **CTA spécifique** et sa position
- **Schema.org recommandé** : Article, FAQPage, Product, HowTo, Course, LocalBusiness, etc.

#### C) SEO & Intent
- **Phase du funnel** : TOFU / MOFU / BOFU
- **Type d'intention** : Informationnelle / Commerciale / Transactionnelle / Navigationnelle
- **10 exemples de requêtes exactes** que ces pages cibleront
- **Compétition estimée** (faible/moyenne/forte) avec justification
- **Potentiel Featured Snippet ou AI Overview** : oui/non et pourquoi

#### D) Avantage compétitif
- Pourquoi ces pages sont **impossibles à copier** par un concurrent
- Quelle **donnée propriétaire** rend chaque page unique

### ÉTAPE 2 — Matrice de priorisation

Classer les modèles dans un tableau :

| Modèle | Pages possibles | Effort par page | Impact SEO | Potentiel conversion | Données déjà dispo ? | PRIORITÉ |
|--------|----------------|----------------|------------|---------------------|----------------------|----------|

### ÉTAPE 3 — Mots-clés par modèle

Pour chaque modèle, générer un tableau de 10-15 mots-clés longue traîne :

| Requête | Intention | Phase funnel | Compétition estimée |
|---------|-----------|-------------|---------------------|

### ÉTAPE 4 — Plan d'exécution 90 jours

Semaine par semaine :
- Quel modèle lancer
- Combien de pages
- Quelles actions techniques
- Prérequis techniques : SSR, sitemap dynamique, schema markup, etc.

### ÉTAPE 5 — Résumé exécutif

- En 5 phrases : pourquoi cette stratégie va fonctionner
- Le modèle #1 à lancer en premier et pourquoi

## Règles non-négociables

Ces règles s'appliquent à CHAQUE page produite par la stratégie :

### Règle 1 — Contenu unique obligatoire (anti-thin content)
Chaque variable change non seulement le H1 mais aussi le CONTENU RÉEL de chaque section. Le template définit la STRUCTURE, jamais le texte. Si deux pages d'un même modèle partagent plus de 30% de texte identique → échec. Chaque section doit être rédigée spécifiquement pour la variable concernée.

### Règle 2 — Données terrain, zéro hallucination
Chaque page est enrichie par les données propriétaires et retours terrain du client (cas réels, erreurs fréquentes, astuces concrètes). Aucun chiffre, aucune statistique, aucun pourcentage ne doit être inventé. Si une donnée n'est pas vérifiable, elle n'apparaît pas.

### Règle 3 — Sourcing obligatoire des données chiffrées
Toute donnée chiffrée DOIT provenir d'une source d'autorité vérifiable et datée de moins de 3 ans.

Protocole pour chaque chiffre publié :
1. Citer la source entre parenthèses : (Source : [Organisme], [Rapport/Étude], [Année])
2. Indiquer l'année de la donnée
3. Si aucune source fiable n'existe → NE PAS inventer. Remplacer par une formulation qualitative ("marché en croissance") ou par le placeholder [DONNÉE À SOURCER — vérifier sur [source recommandée]]

INTERDIT : arrondir "à la louche", extrapoler un chiffre national vers un sous-segment, citer une source sans l'avoir vérifiée.

### Règle 4 — Canonical propre et zéro doublon technique
Chaque page a sa balise canonical qui pointe vers elle-même. Aucun paramètre d'URL, aucune variation ne doit créer de pages dupliquées. Une URL = un contenu = une canonical.

### Règle 5 — Maillage interne différenciant
Chaque page pointe vers un ensemble DIFFÉRENT de pages internes. Le graphe de liens est unique par page. Détailler pour chaque modèle la logique de maillage spécifique.

### Règle 6 — Surprise Score (mémorisation LLM)
Les architectures LLM utilisent un "gradient de surprise" pour décider quoi mémoriser. Contenu prévisible = oublié. Contenu avec données nouvelles, angle contrarien, expertise unique = mémorisé.

Application :
- Chaque section DOIT contenir au moins 1 élément "High Surprise" : donnée propriétaire, angle contrarien, insight absent du web
- Informations High Surprise placées au DÉBUT et à la FIN de chaque section (effet primauté/récence)
- Si une section n'apporte rien de nouveau vs les 10 premiers résultats Google → la réécrire ou la supprimer
- Structure de mémoire associative : chaque paragraphe rappelle le précédent (faible surprise contextuelle) mais ajoute une info nouvelle (haute surprise informationnelle)

### Règle 7 — Grounding Score (Passage Ranking & AI Overview)
Google fonctionne en [Triade SERP](/wiki/triade-serp) : Document Ranking → Passage Ranking → Passage Generation. Si aucun passage n'est assez dense pour être extrait → classé mais invisible dans les réponses IA.

Application :
- Chaque page DOIT contenir 1 "passage ancré" de 150-200 mots : densité sémantique maximale, réponse directe extractible en Featured Snippet ou AI Overview
- Réponse directe en 2-3 phrases AVANT de développer. Format : [Réponse] → [Développement] → [Preuve/Source]
- Chaque page doit inclure 1 "bloc d'authorship algorithmique" (~50 mots) répondant à 100% de la micro-intention cible
- Couvrir la requête principale + 2-3 micro-intentions proches dans des passages distincts pour maximiser le score RRF

## Contraintes de conception

- **Anti-cannibalisation** : ne JAMAIS proposer deux modèles qui ciblent la même personne avec des variables similaires. Si deux modèles se recoupent → les fusionner. Un modèle = un angle unique.
- Chaque modèle DOIT être alimenté par des données que le site possède déjà ou peut générer automatiquement
- Prioriser les modèles où la compétition est FAIBLE et les données sont PROPRIÉTAIRES
- Chaque page doit avoir un CTA clair vers l'une des offres du site
- Penser mobile-first et maillage interne vers les pages piliers existantes

## Format de sortie

Structurer la réponse exactement ainsi :

```
# [URL DU SITE] — Stratégie Programmatique SEO

## Le Principe (3 lignes max)

## Modèle 1 : [Nom]
### Architecture / Template / SEO & Intent / Avantage compétitif
[...jusqu'à Modèle 5 minimum]

## Matrice de Priorisation

## Mots-clés Prioritaires par Modèle

## Plan d'Exécution 90 Jours

## Métriques de Succès

## Résumé Exécutif
```
Product-Led SEO
---
name: seo-product-led
description: |
  Concevoir des outils interactifs et pages dynamiques (Product-Led SEO) pour dominer les requêtes transactionnelles et obtenir la note "Fully Meets" des Quality Raters. Génère des concepts de calculateurs, simulateurs, générateurs optimisés pour l'Agentic Search et la conversion.

  TOUJOURS utiliser ce skill quand l'utilisateur mentionne : Product-Led SEO, outils SEO, calculateur, simulateur, générateur, template interactif, lead magnet, outil gratuit, "créer un outil pour [thématique]", page dynamique, fully meets, Quality Raters, conversion SEO, lead generation SEO, Agentic SEO, ou veut transformer du contenu passif en outil actif.
---

# Product-Led SEO : Outils Interactifs & Pages Dynamiques

Ce skill génère des concepts d'outils interactifs pour dominer les requêtes transactionnelles "Do" et maximiser la conversion organique.

## Quand utiliser ce skill

- Pour créer des lead magnets à fort potentiel SEO
- Pour se différencier des concurrents qui n'ont que du contenu textuel
- Pour cibler les requêtes "calculer", "simuler", "générer", "auditer"
- Pour optimiser la présence dans les réponses des agents IA autonomes

## Concepts clés

### Product-Led SEO
Stratégie où le produit lui-même (outil, calculateur, template) génère du trafic organique et des conversions, plutôt qu'un simple contenu textuel.

### Note "Fully Meets"
La meilleure note que les Quality Raters Google peuvent attribuer. Signifie que la page satisfait **complètement** l'intention de l'utilisateur sans qu'il ait besoin de chercher ailleurs.

### Agentic SEO
Optimisation pour les agents IA autonomes qui peuvent utiliser des outils web à la place de l'humain (MLE-STAR, AutoGPT, Claude Computer Use, etc.).

### Surprise Gap (Mémorisation Titans)
Donnée propriétaire ou unique qui force les modèles IA à mémoriser votre marque plutôt que des informations génériques.

## Instructions

### Étape 1 : Analyser la thématique

Demander à l'utilisateur :
1. **La thématique / le produit** à promouvoir
2. **Les données propriétaires** disponibles (benchmarks internes, cas clients, méthodologies)
3. **Les ressources techniques** (développeur disponible ? budget outil no-code ?)
4. **L'objectif de conversion** (email, démo, essai gratuit, achat)

### Étape 2 : Identifier les micro-intentions "Do"

Lister les tâches concrètes que l'audience cible cherche à accomplir :

Types de micro-intentions "Do" :
- **Calculer** : ROI, budget, coût, temps, économies
- **Simuler** : résultat, scénario, projection, impact
- **Générer** : document, checklist, template, brief
- **Auditer** : score, diagnostic, analyse, benchmark
- **Comparer** : options, offres, solutions, fournisseurs
- **Planifier** : roadmap, calendrier, étapes, ressources

### Étape 3 : Générer le tableau des concepts

Créer un tableau avec **5 concepts d'outils** contenant 5 colonnes :

| Solution Produit | Micro-intention "Do" | Surprise Gap (Mémorisation) | Confidence Score (Preuves) | Action de Conversion |
|------------------|---------------------|----------------------------|---------------------------|---------------------|

### Règles par colonne

#### 1. Solution Produit
Le nom et la fonction précise de l'outil.

Format : **[Type d'outil] + [Bénéfice spécifique]**

Exemples :
- "Calculateur de ROI SEO sur 12 mois"
- "Générateur de brief pour audit technique"
- "Simulateur de trafic par mot-clé"
- "Scorecard d'évaluation d'agence SEO"

#### 2. Micro-intention "Do" ciblée
La tâche exacte que l'utilisateur (ou l'agent IA) cherche à accomplir.

Format : **[Verbe d'action] + [Objet] + [Contexte]**

Exemples :
- "Estimer le budget SEO nécessaire pour atteindre la position 3"
- "Comparer 3 agences SEO sur des critères objectifs"
- "Générer un cahier des charges pour un appel d'offres SEO"

#### 3. Surprise Gap (Mémorisation Titans)
Quelle donnée **propriétaire, unique ou inattendue** l'outil va générer.

Critères du Surprise Gap :
- Basé sur des données réelles de l'entreprise (cas clients anonymisés)
- Impossible à deviner ou reproduire sans expertise terrain
- Crée un "aha moment" qui ancre la marque dans la mémoire
- À éviter : données génériques trouvables partout (ex: "le SEO prend 6 mois")

Exemples de Surprise Gap :
- "Benchmark interne : corrélation entre fréquence de publication et croissance du trafic sur 847 sites analysés"
- "Score prédictif basé sur notre algorithme propriétaire entraîné sur 10 ans de données clients"
- "Comparaison avec 127 entreprises de votre secteur et taille"

#### 4. Confidence Score (Preuves Atomiques)
Format de données **chiffrées et factuelles** que l'outil génère.

L'output doit :
- Être au format structuré (tableau HTML, JSON, PDF)
- Contenir des chiffres précis (pas de fourchettes vagues)
- Être vérifiable et reproductible
- Rassurer le moteur de vérification IA contre les hallucinations

Exemples de formats :
- "Tableau HTML avec 12 KPIs chiffrés + score global /100"
- "Projection mois par mois sur 18 mois avec intervalles de confiance"
- "Checklist de 47 points avec statut binaire Oui/Non"
- "Rapport PDF de 3 pages avec graphiques et recommandations priorisées"

#### 5. Action de Conversion (Lead Gen)
Le workflow exact pour transformer l'utilisation en capture de lead.

Pattern recommandé : **Valeur gratuite → Gate → Valeur premium**

Exemples de workflows :
```
Résultat partiel gratuit (score /100)
→ Email pour débloquer le rapport complet
→ Upsell : audit personnalisé avec expert

Simulation basique gratuite
→ Email pour sauvegarder et recevoir les mises à jour
→ Retargeting : offre d'accompagnement

Checklist générée gratuite
→ Login/email pour télécharger en PDF
→ Nurturing : séquence email avec cas clients
```

### Étape 4 : Évaluer la faisabilité

Pour chaque concept, évaluer :

| Critère | Score 1-5 | Notes |
|---------|-----------|-------|
| Complexité technique | | |
| Données nécessaires | | |
| Temps de développement | | |
| Potentiel SEO (volume requête) | | |
| Potentiel conversion | | |
| Différenciation concurrentielle | | |

### Étape 5 : Spécifications techniques

Pour le concept prioritaire, détailler :

1. **Inputs utilisateur** : quels champs / données demander
2. **Logique de calcul** : formules ou algorithmes
3. **Output généré** : format et contenu du résultat
4. **Données nécessaires** : sources internes ou externes
5. **Stack technique** : technologies recommandées (React, no-code, etc.)

## Notes importantes

- Un outil simple mais utile > un outil complexe inutilisé
- Tester le MVP avec du trafic payant avant d'investir en SEO
- Mettre à jour les données régulièrement pour maintenir le Surprise Gap
- Prévoir une version "agent-friendly" avec API ou embed pour l'Agentic SEO
Pré-audit avant call
---
name: seo-pre-audit
description: >
  Prépare un pré-audit SEO/GEO complet d'un prospect ou d'un client AVANT un
  call, à partir de sa seule URL et de données 100% publiques (aucun outil
  payant, aucune GSC requise). Déroule un protocole de collecte, fait tourner
  une grille de 7 insights business, et produit un document structuré prêt pour
  le call (diagnostic, angle, état SEO, stratégie pSEO multi-axes, roadmap 90
  jours, notes de call). Règle absolue : aucun volume, position ou trafic
  inventé.

  TOUJOURS utiliser ce skill quand l'utilisateur dit : "prépare le pré-call",
  "fais un pré-audit", "audit avant call", "analyse ce prospect", "prépare-moi
  ce client avant le rendez-vous", "pré-call sur [site]", ou quand il fournit
  une URL de prospect/client en demandant une analyse stratégique avant un
  échange commercial.
---

# Pré-audit prospect (avant un call)

Ce skill produit le document qu'on prépare AVANT un call avec un prospect ou un nouveau client. Il transforme une simple URL en une analyse stratégique exploitable, sans aucun accès privé (pas de Google Search Console, pas d'outil payant). Tout repose sur ce qui est public et sur un raisonnement business structuré.

## Le principe de base

Un bon pré-audit ne récite pas des données. Il tranche 2 ou 3 décisions stratégiques nettes : sur quel terrain ce site est défendable, quel problème business lui coûte de l'argent, et par quoi on démarre. Le reste (volumes, positions, trafic) se confirme pendant le call, en demandant l'accès aux données. On ne le simule jamais.

## Règle dure, non négociable

Aucun volume de recherche, aucune position, aucun chiffre de trafic n'est inventé. Tout chiffre non vérifié est marqué `[À SOURCER]` ou « à récupérer au call ». La GSC du prospect est presque toujours indisponible avant le call : on la liste comme question à poser, on ne la devine pas. Un chiffre inventé dans un pré-audit, c'est la crédibilité perdue dès la première vérification.

## Déclencheur

L'utilisateur donne une URL (ou un nom + URL) et demande de préparer le pré-call ou le pré-audit. On déroule alors les trois phases dans l'ordre : collecte (A), grille des 7 insights (B), squelette de sortie (C).

---

## Phase A. Protocole de collecte (avant de raisonner)

Rassembler ce qui est public, dans cet ordre, en notant la source de chaque fait.

1. **Identité et business.** Site principal et sous-domaines liés, page activités/offres, mentions légales, LinkedIn, registres d'entreprises publics (date de création, taille, effectif, labels). On veut savoir : depuis quand ils existent, leur taille, combien de pôles ou métiers ils couvrent, qui décide.

2. **Modèle économique.** Qui paie, pour quoi, panier probable, cycle de vente (lead entrant, appel d'offres, bouche-à-oreille), et le point de conversion réel (devis, démo, prise de rendez-vous, achat).

3. **État SEO technique, sans outil payant.** Ouvrir `/sitemap.xml` et les sitemaps du CMS, compter les pages utiles par section, repérer les pages géographiques ou décisionnelles déjà existantes, la fraîcheur (lastmod), l'architecture des URL. Une refonte en cours est un signal majeur.

4. **Surface GEO.** Le métier produit-il des requêtes décisionnelles qu'une réponse d'IA générative ne dévore pas (B2B de niche, data propriétaire), ou au contraire des requêtes informationnelles que l'IA avale entièrement ? C'est ce qui décide de l'angle.

5. **Données propriétaires.** Produits maison, méthodologie, cas clients, terrain, chiffres internes. C'est le carburant anti-IA et la défendabilité du site.

6. **À demander au call (jamais simulé).** Accès GSC (impressions par mois, position moyenne, top 10, requêtes qui rapportent, leads attribués au SEO), poids de chaque pôle dans le chiffre d'affaires, qui décide, qui pilote la refonte.

Skills complémentaires mobilisables pendant la collecte et le raisonnement, si disponibles : `seo-modeles-pseo`, `seo-mots-cles-decisionnels`, `seo-peurs-objections`, `seo-entites-vectorielles`, `seo-product-led-seo`, `seo-geo-audit`. On les appelle pour structurer l'analyse, jamais pour l'habiller.

---

## Phase B. La grille des 7 insights business (le cœur)

C'est ici que se joue le call. Pour chaque ligne, répondre factuellement à partir de la collecte. Si une réponse est faible, la marquer comme question à poser au call. Un pré-audit réussi, c'est 2 ou 3 de ces insights tranchés net.

| # | Insight | La question qu'on se pose | Ce qu'on en sort |
|---|---|---|---|
| 1 | **Niche défendable** | Sur quel pôle ou offre sont-ils difficiles à attaquer (peu d'acteurs nationaux, intention 100% décisionnelle, data propriétaire, requêtes que l'IA ne mange pas) ? | Le terrain où on attaque en premier, et pourquoi pas le pôle généraliste le plus disputé. |
| 2 | **Le pain qui coûte de l'argent** | Quel problème business non dit perdent-ils aujourd'hui (leads qui partent ailleurs, dépendance au bouche-à-oreille, site refait joli mais invisible, dispersion sur trop de métiers) ? | Le diagnostic interne. Reformulé en « ce que ça vous coûte », jamais répété tel quel au prospect. |
| 3 | **Le levier pSEO multi-axes** | Comment découper chaque pôle en axes (par ville, par type de structure, par fonctionnalité, par problématique) et où est le croisement qui crée l'autorité ? | La stratégie concrète : 4 à 6 modèles de pages, priorisés (voir squelette C.4). |
| 4 | **Le chemin vers le lead** | Chaque page créée renvoie vers quoi ? Où est le point de conversion ? Un outil gratuit (audit, calculateur) capterait-il l'email du décideur au bon moment ? | L'argument « ça ramène des demandes entrantes », pas « ça fait du trafic ». |
| 5 | **Le timing, le hook d'ouverture** | Qu'est-ce qui rend le moment opportun maintenant (refonte en cours, lancement produit, saisonnalité, perte de position) ? | La première phrase du call. Exemple : refonte en cours = « c'est le seul moment où intégrer l'archi SEO coûte presque rien ». |
| 6 | **Les objections probables** | Qu'est-ce qui va bloquer (« on a déjà une agence », « on fait notre site nous-mêmes », « le SEO c'est lent », budget) ? | La réponse préparée pour chaque frein, à dégainer sans hésiter. |
| 7 | **La sortie de call** | Avec quoi le prospect repart-il ? Quel format d'accompagnement colle à sa maturité ? | Le closing : une roadmap 90 jours datée et la proposition adaptée. |

Anti-bullshit : on ne parle pas de « visibilité », on parle de citations IA, de positions, de leads, de conversions. Pas de chiffre inventé. L'insight 2 (le pain) reste une analyse interne, on ne le balance pas frontalement au prospect.

---

## Phase C. Squelette de sortie (à remplir)

Ordre validé : En résumé, puis Diagnostic, Angle, État SEO, pSEO multi-axes, Roadmap 90 jours, Notes de call, À vérifier. Toujours ouvrir par le bloc « En résumé ». Pas de tiret cadratin nulle part. Style direct, factuel, tutoiement si c'est la voix de l'auteur.

```markdown
# Pré-audit — <Prospect> (<domaine>)

## En résumé

[3 à 5 phrases. Qui ils sont, l'état SEO en une ligne, le signal ou la preuve
de pattern s'il existe, l'opportunité en une phrase (le levier pSEO multi-axes),
par quoi on démarre et pourquoi. Finir par le hook du call et la reco de sortie.]

Sources : [URLs et relevés, avec date]. SEO : [sitemaps relevés le YYYY-MM-DD].
GSC non disponible (prospect non connecté), à récupérer au call.

## 1. Diagnostic prospect

**Identité.** [Localisation, ancienneté, taille, labels, cible B2B/B2C.]
**Pôles / offres.** [Liste des métiers et des sites associés.]
**Modèle et conversion.** [Qui paie, pour quoi, point de conversion réel.]
**Pain probable (analyse interne, pas à répéter tel quel).** [Insight 2.]
**À récupérer au call (GSC).** [Impressions/mois, position moyenne, top 10,
requêtes qui rapportent, leads SEO. Aucun chiffre avancé tant que la GSC n'est
pas lue.]

## 2. L'angle : niche défendable d'abord

[Insight 1 : le pôle à attaquer en premier et pourquoi. Défendabilité (peu
d'acteurs, intention décisionnelle, requêtes que l'IA ne mange pas), data
propriétaire réelle, potentiel d'outil gratuit. Puis le second levier, puis ce
qu'on ne fait PAS en premier (le pôle généraliste disputé). Finir par le timing
(insight 5).]

## 3. État des lieux SEO (sitemaps, YYYY-MM-DD)

[Par site ou section : nombre de pages utiles, ce qui existe, ce qui est vide.
Signal clé : la page géo ou décisionnelle déjà présente qui prouve un pattern
jamais décliné = l'ouverture pSEO.]

## 4. La stratégie pSEO : le croisement d'axes

[Le principe : l'autorité vient du croisement de plusieurs axes de découpe par
pôle, pas d'un seul modèle. Puis, par pôle, lister les modèles M1, M2, M3.
Chaque modèle :]

**M<n> — <Axe A> × <Axe B>** (intention visée)
- URL : /<pattern>/. Exemples de pages réelles.
- Variable : <la variable>. Volume estimé : ~N pages.
- Donnée par page : [ce qui remplit la page, terrain réel].
- Dédup / anti-thin : [ce qui existe déjà, la règle anti-page-vide].

### Priorisation

| Modèle | Pages possibles | Effort | Compétition | Intention/conversion | Données dispo | Priorité |
|---|---|---|---|---|---|---|
| M… | ~N | Faible/Moyen/Fort | Faible/Moyenne/Forte | Forte/Très forte | Fortes/Moyennes/Faibles | 1-5 |

Reco : [par quoi on démarre, l'ordre, pourquoi].

### Exemples de requêtes (volumes à sourcer, jamais inventés)
- M1 : [...]
- M2 : [...]

### 7 règles pSEO appliquées
Anti-thin, données terrain (zéro chiffre inventé), sourcing obligatoire,
canonical propre, maillage différenciant par page, au moins un élément de Haute
Surprise par section, passage ancré de 150 à 200 mots avec authorship par page.

## 5. Roadmap 90 jours

- Sem. 1-2 : [cadrage, variables, liste de requêtes par axe (recherche de
  mots-clés + mots-clés décisionnels)].
- Sem. 3-4 : [entités vectorielles + cluster sur les piliers, construction des
  templates].
- Sem. 5-8 : [produire le pilote du modèle prioritaire, maillage croisé,
  resoumission GSC, contrôle d'indexation].
- Sem. 9-12 : [mesurer en GSC, garder ce qui indexe et performe, étendre le
  modèle gagnant, brancher l'outil gratuit].

## 6. Notes pour le call (<durée>)

- Hook d'ouverture : « [insight 5, formulé] »
- Questions à poser : [qui décide, leads web vs autres, accès GSC, qui pilote la
  refonte, poids de chaque pôle dans le CA].
- Freins probables à lever : « [objection] » → [la réponse]. (insight 6)
- Closing : repartir avec la roadmap datée + la proposition adaptée à la
  maturité du prospect. (insight 7)

## 7. À vérifier / suite

- [Sitemaps ou pages à ouvrir pour confirmer.]
- Récupérer la GSC au call pour caler les volumes, la hiérarchie des cibles, les
  chiffres J+90.
- Sortir la vraie liste de requêtes décisionnelles par axe prioritaire + le
  template de page du modèle gagnant.
```

---

## Checklist de qualité avant de livrer

- Le bloc « En résumé » ouvre le document et tranche l'opportunité en une phrase.
- 2 ou 3 insights de la grille sont tranchés net, pas noyés.
- Zéro chiffre inventé : chaque volume/position/trafic est sourcé ou marqué à récupérer.
- L'angle dit clairement par quoi on démarre ET ce qu'on ne fait pas en premier.
- Chaque modèle pSEO a une variable réelle et une donnée qui remplit la page (pas de page vide).
- Le hook d'ouverture et les réponses aux objections sont prêts à dire à l'oral.
- Pas de jargon vide, pas de « visibilité », pas de tiret cadratin.
Le système qui les fait travailler ensemble : J’ai créé un système SEO avec Obsidian, Jev et Claude.